Medición, incertidumbre, estimación y órdenes de magnitud
Física para matemáticos · Tomo I · Capítulo 3
Esta página conserva la edición de 17 de octubre de 2026. La edición canónica revisada reúne los capítulos 0–27 y sus soluciones.
Capítulo 2 · Índice del Tomo I · Capítulo 4
1. Medir no es leer un número
Intuir: una regla parece simple hasta que preguntamos qué significa el número
Coloquemos una regla milimetrada junto a una pequeña barra metálica. A primera vista, el problema parece trivial: alineamos uno de los extremos de la barra con el cero, miramos dónde cae el otro extremo y escribimos un número. Supongamos que obtenemos \(12.4\,\mathrm{cm}.\)
¿Qué hemos hecho exactamente?
Una respuesta apresurada sería:
«Hemos leído la longitud de la barra.»
Pero esa frase comprime varias decisiones distintas.
Primero tuvimos que decidir qué longitud queríamos medir. ¿La distancia entre qué dos puntos de la barra? Si los extremos no son perfectamente planos, ¿qué superficie cuenta como extremo? ¿La barra está a temperatura ambiente? ¿Está comprimida por el dispositivo de medida? ¿La regla está alineada con el eje de la barra o ligeramente inclinada?
Después elegimos un procedimiento: apoyar una regla, hacer coincidir un extremo con una marca de referencia y estimar la posición del otro extremo sobre una escala graduada. Luego obtuvimos una indicación: cierta posición visual respecto de las marcas.
Finalmente convertimos esa indicación en una afirmación cuantitativa: \(L\approx12.4\,\mathrm{cm}.\) El número no apareció solo. Es el extremo visible de una cadena física y conceptual.
Principio 3.1 — Medir exige declarar qué magnitud se pretende medir Antes de interpretar un número como resultado físico debemos identificar la magnitud que se pretende medir, el sistema al que pertenece y las condiciones relevantes bajo las cuales se realiza el procedimiento.
Esta exigencia continúa la gramática del capítulo 1. Allí distinguimos el sistema físico de su representación matemática. Ahora añadimos un nuevo puente:
\[\boxed{ \text{sistema físico} \to \text{mensurando} \to \text{procedimiento} \to \text{indicación} \to \text{resultado de medición}. }\]
El resto del capítulo estudia qué información se conserva y qué limitaciones aparecen en cada flecha.
Representar: del fenómeno al mensurando
En metrología se llama mensurando a la magnitud que se pretende medir.1
La palabra es útil porque obliga a formular una pregunta que suele quedar implícita:
¿Qué magnitud, exactamente, queremos atribuir al sistema?
Por ejemplo, frente a una barra metálica podemos interesarnos por:
su longitud entre dos caras determinadas;
su diámetro medio;
su masa;
su temperatura;
su resistividad eléctrica;
el tiempo que tarda una perturbación mecánica en atravesarla.
Todos estos son mensurandos diferentes.
Incluso la frase «la longitud de la barra» puede ser insuficiente si las condiciones importan. Una barra se dilata térmicamente. Por tanto, una especificación suficientemente precisa puede requerir algo como:
longitud entre las dos caras terminales, a una temperatura especificada y bajo determinadas condiciones de apoyo.
No siempre necesitaremos ese nivel de detalle. Pero debemos saber que la definición del mensurando forma parte del problema físico.
Definición operativa 3.1 — Medición Una medición es un proceso experimental mediante el cual obtenemos información cuantitativa que permite atribuir uno o más valores a una magnitud. La medición incluye un procedimiento, instrumentos o sistemas de medición, condiciones de operación y un modelo de interpretación; no se reduce a copiar un número de una pantalla.2
Definición operativa 3.2 — Mensurando El mensurando es la magnitud que se pretende medir. Identificarlo exige especificar con suficiente claridad qué propiedad del sistema físico está siendo cuantificada.3
La palabra «pretende» es importante. El instrumento no decide por nosotros qué estamos midiendo. Un sensor puede producir una señal eléctrica. Para interpretarla como temperatura, presión, aceleración o cualquier otra magnitud necesitamos un modelo de medición que conecte la señal con el mensurando.
No-ejemplo: un número sin mensurando
Supongamos que una pantalla muestra
\[3.72.\]
¿Es un resultado físico?
Todavía no.
No sabemos:
qué magnitud representa;
en qué unidad está expresada;
bajo qué condiciones se obtuvo;
qué procedimiento produjo la indicación;
con qué resolución trabaja el dispositivo;
qué incertidumbre acompaña la atribución del valor.
El mismo número podría significar
\[3.72\,\mathrm V, \qquad 3.72\,\mathrm{m/s}, \qquad 3.72\,\mathrm K, \qquad 3.72\,\mathrm{kg},\]
o muchas otras cosas.
El capítulo 2 nos enseñó que una cantidad física no es un número desnudo. Ahora añadimos que incluso una cantidad con unidad puede no ser todavía un resultado de medición completo.
Una indicación tampoco es todavía el resultado completo
El VIM llama indicación al valor proporcionado por un instrumento o sistema de medición.4
En una balanza digital podríamos leer
\[152.37\,\mathrm g.\]
Ésa es una indicación. Pero un resultado de medición puede requerir más información. Puede haber una corrección de calibración, una contribución debida a la resolución, variación entre repeticiones o influencia de la temperatura.
Por eso debemos distinguir:
\[\boxed{ \text{indicación} \neq \text{resultado de medición completo}. }\]
Principio 3.2 — Una indicación instrumental no es todavía un resultado de medición completo La lectura mostrada por un dispositivo es una entrada del proceso de interpretación. Para convertirla en resultado debemos saber qué representa, qué correcciones o modelo intervienen y qué incertidumbre acompaña a los valores atribuidos al mensurando.
Definir: resultado de medición
El VIM formula el resultado de medición de una manera deliberadamente más rica que «un número obtenido al medir». Un resultado es un conjunto de valores atribuidos al mensurando junto con la información relevante disponible; en muchos casos se expresa mediante un valor medido acompañado por una incertidumbre.5
Para el nivel de este capítulo usaremos la siguiente formulación operacional.
Definición operativa 3.3 — Resultado de medición Un resultado de medición es una atribución cuantitativa al mensurando que incluye el valor o los valores representativos obtenidos y la información necesaria para interpretar su alcance. En el caso usual que estudiaremos, se expresará mediante un valor medido, una unidad y una declaración de incertidumbre.
Esquemáticamente,
\[\boxed{ \text{resultado} = \text{valor atribuido} + \text{unidad} + \text{información de incertidumbre}. }\]
Esta escritura es conceptual, no una suma algebraica.
Matemática exacta sobre datos no exactos
Supongamos que una mesa tiene lados medidos como \(a=1.24\,\mathrm m, \qquad b=0.73\,\mathrm m.\) La multiplicación decimal puede hacerse exactamente: \(1.24\times0.73=0.9052.\) Pero de ello no se sigue que el área física sea conocida exactamente como \(A=0.9052\,\mathrm{m^2}.\)
La operación matemática puede ser exacta relativamente a los números introducidos, mientras que esos números provienen de mediciones de alcance finito.
Esta distinción será central en todo el capítulo:
\[\boxed{ \text{cálculo exacto sobre los datos} \neq \text{conocimiento físico exacto del mensurando}. }\]
La calculadora puede producir más dígitos que los que la experiencia justifica.
Principio 3.3 — Más dígitos no implican más información física La cantidad de cifras producidas por una operación matemática o una calculadora no determina la información contenida en las mediciones de entrada. El reporte final debe conservar la precisión físicamente justificada, no la longitud de la expansión decimal calculada.
Representar: resolución finita
Volvamos a la regla milimetrada. Si la menor división visible de la escala es \(1\,\mathrm{mm},\)
no podemos tratar la lectura como si el instrumento distinguiera arbitrariamente pequeñas diferencias. El VIM define la resolución como el menor cambio de la magnitud medida que produce un cambio perceptible en la indicación correspondiente.6
En instrumentos digitales aparece una idea semejante. Si una balanza muestra valores en pasos de
\[0.01\,\mathrm g,\]
entonces muchas masas físicas cercanas pueden producir la misma indicación visible. Por ejemplo, dos objetos podrían mostrar ambos
\[25.37\,\mathrm g,\]
aunque sus masas no sean físicamente idénticas.
Lo importante es lógico:
\[\boxed{ \text{misma indicación} \not\Rightarrow \text{mismo valor físico exacto}. }\]
Este hecho no es una imperfección accidental. Surge de que la interacción experimental y el dispositivo poseen capacidad finita de discriminación.
Ejemplo: una lectura analógica y una lectura digital
Caso A — regla
Una regla tiene marcas cada
\[1\,\mathrm{mm}.\]
El extremo de un objeto cae aproximadamente entre las marcas de
\[12.3\,\mathrm{cm} \quad\text{y}\quad 12.4\,\mathrm{cm}.\]
El observador puede intentar interpolar visualmente, pero esa interpolación no convierte la regla en un instrumento de resolución infinita.
Caso B — pantalla digital
Un termómetro muestra
\[21.7\,^{\circ}\mathrm C.\]
La cifra decimal no implica que la temperatura real del cuerpo sea exactamente \(21.7000\ldots\,^{\circ}\mathrm C\). Además, la resolución de la pantalla no agota la incertidumbre. Pueden intervenir calibración, estabilidad, gradientes térmicos, contacto imperfecto o respuesta temporal.
Este ejemplo anticipa una distinción que formalizaremos después:
\[\boxed{ \text{resolución} \neq \text{incertidumbre total}. }\]
Variar: repetir la medición
Midamos diez veces el período de un mismo péndulo bajo condiciones nominalmente iguales. Podríamos obtener, en segundos, \(2.01, \ 2.03, \ 2.00, \ 2.02, \ 2.01, \ldots\)
¿Hay una contradicción?
No. Una medición real puede variar entre repeticiones porque las condiciones nunca se reproducen de manera absolutamente idéntica, porque existe ruido, porque el procedimiento tiene resolución finita o porque intervienen efectos no controlados. La dispersión no convierte automáticamente la experiencia en «mala». Es información acerca del proceso de medición.
En §§3–5 estudiaremos cómo describir esa dispersión y cómo contribuye a la incertidumbre. Por ahora basta observar que un resultado de medición no debe tratarse como si el único problema experimental consistiera en revelar más y más decimales de un número exacto mediante una pantalla imperfecta.
Espacio de ejemplos y no-ejemplos
Clasifiquemos varias expresiones.
Ejemplo 1
\[L=24.6\,\mathrm{cm}.\]
Podría ser una indicación o un valor medido, pero sin contexto no sabemos todavía cómo interpretar su alcance.
Ejemplo 2
\[L=(24.6\pm0.1)\,\mathrm{cm}.\]
Ahora aparece una información adicional, pero todavía debemos preguntar qué significa \(0.1\,\mathrm{cm}\): ¿resolución?, ¿incertidumbre estándar?, ¿incertidumbre expandida?, ¿una cota adoptada?
La notación \(\pm\) por sí sola no explica su semántica.
No-ejemplo 1
«La longitud verdadera es exactamente \(24.6\,\mathrm{cm}\) porque eso mostró la regla.»
La conclusión excede la información disponible.
No-ejemplo 2
«Como dos mediciones dieron números diferentes, una de las dos está necesariamente mal.»
También es falso. Una serie de mediciones puede dispersarse aun cuando el procedimiento sea adecuado.
No-ejemplo 3
«Una balanza que muestra cinco decimales es necesariamente más exacta que una que muestra tres.»
El número de dígitos visibles no basta para evaluar la exactitud del sistema de medición.
Primera noción de incertidumbre
El VIM define la incertidumbre de medición como un parámetro no negativo que caracteriza la dispersión de los valores atribuidos al mensurando sobre la base de la información utilizada.7
Todavía no desarrollaremos la definición técnica completa. Pero sí podemos fijar desde ahora su función conceptual.
La incertidumbre responde, de forma cuantitativa, a la pregunta:
¿qué tan estrechamente queda determinada la atribución de valores al mensurando por la información disponible?
No debe confundirse con ignorancia absoluta ni con un error que conocemos pero decidimos ocultar.
Tampoco debemos imaginar que toda incertidumbre proviene de fluctuaciones aleatorias. Algunas contribuciones se evalúan estadísticamente; otras provienen de calibraciones, especificaciones instrumentales, resoluciones, modelos o información previa. El VIM distingue precisamente evaluaciones de tipo A y tipo B.8
Estas distinciones se desarrollarán en §§4–5.
Red: la cadena completa
Podemos ahora ampliar la cadena metodológica del capítulo 1 y capítulo 2.
En el capítulo 1 teníamos:
\[\text{fenómeno} \to \text{sistema} \to \text{modelo}.\]
En el capítulo 2 aprendimos a representar magnitudes mediante valores y unidades, y a controlar dimensiones y escalas.
Ahora añadimos la capa experimental:
\[\boxed{\begin{gathered} \text{fenómeno} \to \text{mensurando}\\[2pt]\Downarrow\\[2pt]\text{procedimiento} \to \text{indicación}\\[2pt]\Downarrow\\[2pt]\text{modelo de medición} \to \text{resultado + incertidumbre}. \end{gathered}}\]
Esta cadena no es puramente matemática. El paso de una indicación a un resultado exige conocimiento físico del instrumento, del procedimiento y de las condiciones experimentales.
Práctica MA-PED
Ejercicio 3.1 — ¿Qué falta para que haya un resultado?
Un dispositivo muestra 7.42.
A. Enumera al menos cinco datos conceptuales que faltan antes de interpretar esa indicación como resultado de medición.
B. Explica por qué añadir la unidad V mejora la información pero todavía no resuelve completamente el problema.
C. Propón una formulación mínima de mensurando para una medición eléctrica sencilla.
Solución
A. Faltan, entre otros: la magnitud que se pretende medir, la unidad, el objeto o sistema, el procedimiento, el intervalo/rango de operación relevante, la resolución, las condiciones de medición y la información de incertidumbre.
B. Escribir \(7.42\,\mathrm V\) identifica una unidad compatible con diferencia de potencial, pero no especifica entre qué puntos se mide, con qué instrumento, bajo qué condiciones ni con qué incertidumbre.
C. Por ejemplo: «diferencia de potencial entre los terminales A y B de la fuente, medida con el voltímetro X bajo régimen estacionario». La formulación aún puede perfeccionarse, pero ya identifica mucho mejor el mensurando.
Ejercicio 3.2 — Dígitos de calculadora y conocimiento físico
Se miden los lados de una placa rectangular: \(a=1.24\,\mathrm m, \qquad b=0.73\,\mathrm m.\) Una calculadora entrega
\[ab=0.9052\,\mathrm{m^2}.\]
A. ¿Qué parte de esta igualdad es matemáticamente exacta?
B. ¿Por qué no se sigue automáticamente que el área física sea conocida con cuatro cifras decimales?
C. Formula en una frase la diferencia entre exactitud del cálculo y alcance de los datos.
Solución
A. La multiplicación \(1.24\times0.73=0.9052\) es exacta como operación sobre esos números decimales.
B. Los números \(1.24\) y \(0.73\) representan resultados de medición con información finita. Las cifras de salida no pueden crear información que no estaba contenida en las entradas.
C. El cálculo puede ser exacto respecto de los datos numéricos y, al mismo tiempo, el valor físico inferido seguir siendo incierto.
Ejercicio 3.3 — Misma indicación, ¿misma magnitud?
Una balanza digital con paso de indicación de \(0.01\,\mathrm g\) muestra \(25.37\,\mathrm g\) para dos pequeños objetos.
A. ¿Podemos concluir que sus masas son exactamente iguales?
B. ¿Qué sí podemos afirmar a partir de la información disponible?
C. Explica por qué la resolución de la pantalla no debe identificarse sin más con la incertidumbre total.
Solución
A. No. Diferentes valores físicos suficientemente cercanos pueden producir la misma indicación visible.
B. Podemos afirmar que, bajo ese procedimiento y en ese momento, ambos objetos produjeron la misma indicación mostrada por la balanza.
C. La incertidumbre puede incluir otras contribuciones: calibración, estabilidad, repetibilidad, condiciones ambientales, modelo de corrección, etc. La resolución es una contribución posible, no una descripción completa del resultado.
Cierre
La pregunta inicial parecía elemental:
¿qué significa medir una longitud con una regla?
La respuesta ya no puede ser «leer un número».
Medir exige construir una relación controlada entre un sistema físico y una atribución cuantitativa. La unidad mínima de lectura será, por tanto,
\[\boxed{ (\text{mensurando},\ \text{procedimiento},\ \text{indicación},\ \text{modelo},\ \text{resultado},\ \text{incertidumbre}). }\]
En la siguiente sección examinaremos el componente que primero hace visible el carácter finito de toda medición instrumental (§2).
2. Instrumentos, escalas y resolución
Intuir: dos pantallas iguales no garantizan dos mediciones igualmente informativas
Imaginemos dos termómetros digitales colocados en el mismo laboratorio. Ambos muestran
\[21.7\,^{\circ}\mathrm C.\]
A primera vista podríamos pensar que proporcionan exactamente la misma información.
Pero supongamos ahora que:
el primero actualiza su pantalla en pasos de \(0.1\,^{\circ}\mathrm C\);
el segundo también muestra una décima de grado, pero internamente utiliza un sensor con una respuesta mucho más estable;
el primero no ha sido calibrado recientemente;
el segundo posee un certificado de calibración;
uno tarda varios minutos en alcanzar equilibrio térmico y el otro responde con rapidez.
La coincidencia de las pantallas no basta para concluir que los dos sistemas de medición se comportan de la misma manera. Tampoco basta el número de cifras visibles.
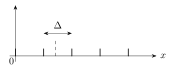
Figura 3.1. Las marcas vecinas están separadas por \(\Delta\). La posición entre marcas exige un procedimiento de lectura y una evaluación de incertidumbre; la resolución no determina por sí sola toda la incertidumbre de la medición. Véase §2.
Este capítulo necesita, por tanto, separar varias preguntas:
¿qué magnitud entra en interacción con el instrumento?;
¿qué señal produce esa interacción?;
¿cómo se transforma la señal en una indicación?;
¿qué cambios puede distinguir el sistema?;
¿qué parte de la información disponible queda oculta por la representación final?
La idea central de esta sección será:
\[\boxed{ \text{instrumento} \neq \text{pantalla} }\]
y, más precisamente,
\[\boxed{ \text{número mostrado} \neq \text{capacidad total del sistema de medición}. }\]
Representar: un instrumento como parte de una cadena
Un instrumento de medición no es una caja que «contiene» el valor del mensurando. En una medición típica ocurre una cadena de interacciones.
Por ejemplo, en un termómetro electrónico podemos representar esquemáticamente:
\[\begin{gathered} \text{temperatura}\\[2pt]\Downarrow\\[2pt]\text{propiedad sensible del sensor}\\[2pt]\Downarrow\\[2pt]\text{señal eléctrica} \longrightarrow \text{procesamiento}\\[2pt]\Downarrow\\[2pt]\text{indicación}. \end{gathered}\]
En una balanza digital:
\[\text{fuerza sobre el sensor} \longrightarrow \text{deformación o señal} \longrightarrow \text{conversión} \longrightarrow \text{indicación de masa}.\]
En una regla graduada, la cadena es menos electrónica, pero no desaparece:
\[\begin{gathered} \text{posición del extremo}\\[2pt]\Downarrow\\[2pt]\text{comparación con marcas}\\[2pt]\Downarrow\\[2pt]\text{percepción/interpolación} \longrightarrow \text{indicación}. \end{gathered}\]
El instrumento forma parte del procedimiento de medición. Su salida debe interpretarse dentro de un modelo que conecta lo que el dispositivo responde con el mensurando que queremos determinar.
Definir: indicación
En §1 utilizamos la palabra indicación de manera preliminar. Ahora la fijamos como término técnico.
Definición operativa 3.4 — Indicación Una indicación es el valor de una magnitud proporcionado por un instrumento o sistema de medición. Es una salida del sistema de medición; no debe confundirse automáticamente con el resultado final atribuido al mensurando.9
Por ejemplo, una balanza puede indicar
\[m_{\mathrm{ind}}=152.37\,\mathrm g.\]
Si existe una corrección de calibración \(c\), el valor utilizado en el resultado podría modelarse, en un caso elemental, como \(m=m_{\mathrm{ind}}+c.\)
Esta ecuación no es universal. Es un modelo de medición muy simple que ilustra una idea importante:
\[\boxed{ \text{indicación} \quad\text{puede ser una entrada del modelo de medición}. }\]
La indicación es observable en el dispositivo. El mensurando, en cambio, es la magnitud que queremos determinar.
Escalas analógicas: leer implica comparar
Consideremos una regla cuyas marcas están separadas por \(1\,\mathrm{mm}.\) Si el extremo de un objeto cae entre dos marcas, la lectura no consiste en encontrar una marca que coincida mágicamente con el extremo. El observador compara posiciones e interpola. Podemos tener, por ejemplo, \(x\approx 37.4\,\mathrm{mm}.\)
aunque la escala sólo marque milímetros enteros.
¿Significa esto que la regla posee una resolución de \(0.1\,\mathrm{mm}\)?
No necesariamente. La posibilidad de interpolar visualmente y la capacidad efectiva del sistema para distinguir cambios son cuestiones relacionadas, pero no idénticas. La anchura de las marcas, el paralaje, el contraste, la alineación y el procedimiento del observador influyen.
Por eso no adoptaremos la regla ingenua
«la incertidumbre es siempre la mitad de la división mínima».
En algunos ejercicios introductorios esa convención puede ser una aproximación útil bajo hipótesis explícitas. No es una ley universal de la medición.
Resolución: capacidad de distinguir cambios
El VIM define la resolución mediante la respuesta del sistema: es el menor cambio en la magnitud medida que produce un cambio perceptible en la indicación correspondiente.10
Definición operativa 3.5 — Resolución La resolución de un sistema de medición caracteriza el menor cambio de la magnitud medida que puede producir un cambio perceptible en la indicación, bajo las condiciones consideradas.11
La palabra perceptible debe interpretarse de acuerdo con el tipo de sistema. En una pantalla digital cuya última cifra cambia en pasos de
\[0.01\,\mathrm g,\]
la resolución de visualización está vinculada a esa separación entre indicaciones posibles.12
En una escala analógica, el problema incluye la capacidad de distinguir desplazamientos de una aguja o de una posición respecto de las divisiones. No debemos, sin embargo, reducir la resolución a una propiedad tipográfica de la pantalla. El sistema completo puede tener limitaciones anteriores a la visualización.
Una primera separación conceptual
Conviene fijar desde ahora cuatro conceptos que más adelante estudiaremos por separado:
\[\boxed{ \text{resolución} \neq \text{precisión} \neq \text{exactitud} \neq \text{incertidumbre}. }\]
Por ahora basta una caracterización preliminar.
Resolución: capacidad de distinguir cambios en la indicación.
Precisión: se relacionará con la proximidad entre resultados o indicaciones repetidos bajo condiciones especificadas.
Exactitud: se relacionará con la proximidad entre un valor medido y un valor verdadero del mensurando; el VIM no la trata como una cantidad a la que simplemente asignamos un número.13
Incertidumbre: caracterizará cuantitativamente la dispersión de valores atribuidos al mensurando a partir de la información disponible.
Estas distinciones impiden varios razonamientos incorrectos.
Error plausible A
«El instrumento tiene muchas cifras, luego es muy exacto.»
No se sigue.
Error plausible B
«La pantalla cambia de \(0.01\) en \(0.01\), luego la incertidumbre es exactamente \(0.01\).»
Tampoco se sigue.
Error plausible C
«Dos objetos dan la misma indicación, luego tienen exactamente el mismo valor del mensurando.»
Tampoco. La última afirmación admite una formulación matemática particularmente clara.
Modelar: una pantalla digital como cuantizador
Para entender qué información pierde una indicación digital, construyamos un modelo idealizado.
Supongamos que un instrumento muestra valores separados por un paso fijo
\[\Delta>0.\]
Podemos representar una regla de redondeo mediante
\[Q_{\Delta}(x) = \Delta \operatorname{round}\!\left(\frac{x}{\Delta}\right).\]
La función
\[Q_{\Delta}:\mathbb R\to \Delta\mathbb Z\]
asigna a muchos valores reales la misma indicación. Por ejemplo, con
\[\Delta=0.01\,\mathrm g,\]
todos los valores de un intervalo apropiado alrededor de
\[25.37\,\mathrm g\]
pueden producir la misma indicación
\[25.37\,\mathrm g.\]
Este modelo no pretende describir todos los detalles electrónicos de una balanza real. Su función es aislar una estructura:
\[\boxed{ \text{la representación de la indicación puede ser muchos-a-uno}. }\]
La información mostrada es entonces una representación más gruesa o discretización de un conjunto más fino de posibles entradas.
Proposición: igualdad de indicaciones no implica igualdad física exacta
Proposición 3.1 — No inyectividad de una indicación cuantizada
Sea \(\Delta>0\) y definamos
\[Q_{\Delta}(x) = \Delta \operatorname{round}\!\left(\frac{x}{\Delta}\right).\]
Entonces existen \(x\neq y\) tales que
\[Q_{\Delta}(x)=Q_{\Delta}(y).\]
Por tanto, dentro de este modelo, la igualdad de indicaciones no permite inferir la igualdad exacta de los valores de entrada.
Demostración.
Tomemos, por ejemplo,
\[x=0\]
y
\[y=\frac{\Delta}{4}.\]
Como
\[\left|\frac{y}{\Delta}\right| = \frac14 < \frac12,\]
ambos valores se redondean al mismo múltiplo de \(\Delta\): \(Q_{\Delta}(0)=0,\)
y
\[Q_{\Delta}\!\left(\frac{\Delta}{4}\right)=0.\]
Pero
\[0\neq\frac{\Delta}{4}.\]
Por tanto,
\[Q_{\Delta}(x)=Q_{\Delta}(y) \not\Rightarrow x=y. \qquad\square\]
La proposición es matemática y exacta dentro del modelo de cuantización elegido. Su interpretación física requiere recordar que un instrumento real puede incluir ruido, histéresis, filtros, calibración, saturación y otros efectos. No estamos afirmando que toda pantalla real implemente exactamente \(Q_\Delta\).
El valor pedagógico del modelo consiste en hacer visible el salto lógico incorrecto:
\[\boxed{ \text{misma representación} \not\Rightarrow \text{misma realidad física exacta}. }\]
Intervalo de medición y saturación
Todo instrumento funciona dentro de un dominio operativo. Una balanza diseñada para medir hasta
\[200\,\mathrm g\]
no debe tratarse como si siguiera proporcionando información fiable para una masa de
\[5\,\mathrm{kg}.\]
Un voltímetro puede saturarse. Un sensor puede abandonar su región lineal. Una cámara puede registrar una zona completamente blanca aunque la intensidad de luz siga aumentando.
En estos casos, el problema no es simplemente que «falte un decimal». La relación entre entrada física e indicación ha alcanzado una región donde el sistema ya no discrimina de la forma prevista. Una indicación situada fuera del intervalo de funcionamiento especificado puede carecer del significado que tendría dentro de él.
Esto anticipa una regla general de modelización:
\[\boxed{ \text{una medición también posee un dominio de validez}. }\]
La idea enlaza directamente con el capítulo 1: un sistema de medición es también un modelo físico con condiciones de aplicación.
Umbral de discriminación
El VIM distingue la resolución del umbral de discriminación, relacionado con el mayor cambio en la magnitud medida que todavía no produce un cambio detectable en la indicación.14
La distinción es útil porque obliga a preguntar:
¿qué cambio debe ocurrir antes de que el sistema responda de manera observable?
En un instrumento ideal de escalones perfectos, resolución y umbral pueden parecer casi la misma cuestión. En sistemas reales pueden intervenir fricción, histéresis, ruido, filtros o umbrales electrónicos. No necesitamos todavía formalizar todos esos efectos. Basta reconocer que una especificación como \(0.01\,\mathrm g\)
no describe por sí sola toda la capacidad discriminante del instrumento.
Variar: cambiar el modo de mostrar sin cambiar el sensor
Supongamos un sensor cuya electrónica interna produce una señal numérica con muchos dígitos.
El fabricante puede decidir mostrar:
Modo A
\[21.7\,^{\circ}\mathrm C\]
o
Modo B
\[21.70\,^{\circ}\mathrm C.\]
¿Ha mejorado necesariamente el sistema de medición?
No.
Cambiar el formato de la pantalla puede añadir una cifra visible sin mejorar:
la calibración;
la estabilidad;
el contacto térmico;
la repetibilidad;
el modelo de corrección;
la incertidumbre total.
La interfaz puede mostrar más dígitos de los que el resto del sistema justifica.
Ésta es otra forma de la advertencia de §1:
\[\boxed{ \text{resolución de visualización} \neq \text{información física total}. }\]
Ejemplo trabajado: una balanza con paso de \(0.01\,\mathrm g\)
Supongamos una balanza cuyo modelo idealizado de visualización es \(Q_{\Delta}(m), \qquad \Delta=0.01\,\mathrm g.\) La pantalla indica
\[25.37\,\mathrm g.\]
Si el dispositivo redondea al valor más cercano, entonces una entrada dentro del intervalo
\[25.365\,\mathrm g \le m < 25.375\,\mathrm g\]
puede representarse como \(25.37\,\mathrm g,\)
salvo la convención exacta adoptada para resolver los casos en los puntos medios. Este intervalo no es todavía un intervalo de incertidumbre de medición. Sólo expresa qué entradas son compatibles con una regla de cuantización idealizada.
Ésta es una distinción esencial:
\[\boxed{ \text{intervalo de cuantización} \neq \text{intervalo de incertidumbre}. }\]
En una medición real podrían existir además contribuciones por calibración, deriva, temperatura, repetibilidad u otros efectos.
Práctica MA-PED
Ejercicio 3.4 — Leer una escala sin inventar información
Función pedagógica: Consolidación → Diagnóstico.
Una regla posee marcas cada \(1\,\mathrm{mm}\). Un estudiante observa que el extremo de una pieza se encuentra aproximadamente a \(4\) décimas de la distancia entre las marcas de \(37\,\mathrm{mm}\) y \(38\,\mathrm{mm}\).
Propón una indicación razonable.
¿Permite la interpolación afirmar que la resolución física del sistema completo es exactamente \(0.1\,\mathrm{mm}\)?
Enumera al menos tres efectos que podrían limitar la lectura.
Explica por qué no es correcto concluir que la incertidumbre total vale automáticamente \(\pm0.05\,\mathrm{mm}\).
Solución
- Una indicación razonable es
\[x_{\mathrm{ind}}\approx37.4\,\mathrm{mm}.\]
No. La interpolación visual permite construir una estimación entre marcas, pero la capacidad efectiva de distinguir cambios depende del sistema completo y del procedimiento.
Entre los efectos posibles están:
anchura de las marcas;
paralaje;
alineación de la pieza;
resolución visual del observador;
definición geométrica del extremo;
deformación o temperatura de la pieza.
La regla \(\pm\) media división puede usarse como modelo elemental cuando se declara explícitamente, pero no constituye una ley universal. La incertidumbre puede incluir otras contribuciones y su interpretación debe especificarse.
Ejercicio 3.5 — Una pantalla como función muchos-a-uno
Función pedagógica: Reconstrucción → Prueba de estrés.
Considera
\[Q_{\Delta}(x) = \Delta \operatorname{round}\!\left(\frac{x}{\Delta}\right), \qquad \Delta=0.01\,\mathrm g.\]
Determina un intervalo de valores que se muestren como \(25.37\,\mathrm g\) bajo redondeo al más cercano.
Encuentra dos valores diferentes de masa que produzcan esa misma indicación.
¿Puede interpretarse ese intervalo directamente como la incertidumbre de la medición?
¿Qué conclusión lógica sí puede extraerse con seguridad del modelo?
Solución
- Ignorando la convención especial de desempate en los puntos medios, el intervalo es
\[25.365\,\mathrm g \le m < 25.375\,\mathrm g.\]
- Por ejemplo,
\[m_1=25.368\,\mathrm g, \qquad m_2=25.372\,\mathrm g\]
producen ambos
\[Q_{\Delta}(m_1)=Q_{\Delta}(m_2)=25.37\,\mathrm g.\]
No. El intervalo proviene únicamente del modelo de cuantización. La incertidumbre de una medición real puede incorporar más información y más fuentes de variabilidad.
Sí podemos concluir que, bajo este modelo,
\[\boxed{ Q_{\Delta}(m_1)=Q_{\Delta}(m_2) \not\Rightarrow m_1=m_2. }\]
La igualdad de indicaciones no demuestra igualdad física exacta.
Autoexplicación: cuatro preguntas antes de confiar en una cifra
Ante una lectura instrumental, el lector debería aprender a preguntar:
¿qué mensurando se intenta determinar?
¿qué parte del sistema produce esta indicación?
¿qué cambios puede distinguir el dispositivo?
¿qué otras contribuciones podrían afectar al resultado?
Estas preguntas impiden que la pantalla sustituya al razonamiento físico. Una medición no es buena porque tenga muchos decimales. Es informativa cuando comprendemos qué relación existe entre el mensurando, el instrumento, la indicación y las limitaciones del procedimiento.
Conectar: la resolución no explica la dispersión entre repeticiones
Hasta ahora hemos examinado principalmente la capacidad de un sistema para distinguir cambios. Pero incluso un instrumento de resolución fija puede producir una serie como
\[10.02,\quad 10.04,\quad 10.01,\quad 10.03,\quad 10.02.\]
La siguiente pregunta será distinta:
¿qué información contiene la dispersión de mediciones repetidas?
Eso nos lleva a (§3).
Allí podremos distinguir por primera vez la resolución del instrumento de la variabilidad observada en una serie de mediciones.
3. Repetición, dispersión y precisión
Intuir: repetir no significa obtener el mismo número
Supongamos que medimos cinco veces el período de un péndulo bajo condiciones que intentamos mantener tan semejantes como sea razonable. Obtenemos, en segundos,
\[2.01,\quad 2.03,\quad 2.00,\quad 2.02,\quad 2.01.\]
La primera tentación puede ser preguntar:
¿Cuál de estos números es el correcto?
Pero esa pregunta ya presupone que cuatro de los cinco deben ser descartados.
Una lectura más informativa es distinta:
¿Qué nos dice el conjunto completo de resultados sobre el procedimiento de medición?
La variación entre repeticiones contiene información.
No es simplemente «ruido que hay que borrar».
Puede revelar:
sensibilidad del procedimiento a pequeñas diferencias de condiciones;
fluctuaciones del sistema;
limitaciones del instrumento;
variación en la intervención del observador;
efectos ambientales;
componentes aleatorias del proceso de medición.
El cambio de perspectiva es fundamental:
\[\boxed{ \text{una serie de mediciones} \neq \text{varias oportunidades de acertar el mismo número}. }\]
Una serie es un objeto de estudio.
Representar: una serie de mediciones
Escribamos una serie de \(n\) valores medidos como \(x_1,x_2,\ldots,x_n.\)
Podemos pensarla como un vector de datos
\[\mathbf x=(x_1,\ldots,x_n)\in\mathbb R^n\]
cuando todos los valores están expresados en la misma unidad.
Esta representación nos permite formular dos preguntas diferentes:
¿dónde se encuentra aproximadamente el centro de la serie?;
¿cuánto se dispersan los valores alrededor de ese centro?
La primera pregunta conduce a medidas de localización, como la media aritmética. La segunda conduce a medidas de dispersión. Ambas son necesarias.
Dos series pueden tener la misma media y comportarse de manera muy distinta.
Definir: precisión de medición
El VIM utiliza precisión de medición para describir la cercanía entre indicaciones o valores medidos obtenidos mediante mediciones repetidas del mismo objeto o de objetos similares bajo condiciones especificadas.15
Definición operativa 3.6 — Precisión de medición La precisión de medición caracteriza cuán próximos se encuentran entre sí los resultados o indicaciones de mediciones repetidas realizadas bajo condiciones especificadas. Una dispersión menor corresponde, en ese sentido, a una mayor precisión.16
La frase bajo condiciones especificadas es indispensable.
No tiene sentido comparar precisión sin declarar si las mediciones se realizaron:
con el mismo instrumento;
por el mismo observador;
en un intervalo de tiempo corto;
bajo condiciones ambientales semejantes;
mediante el mismo procedimiento.
El VIM llama repetibilidad de medición a la precisión bajo un conjunto de condiciones de repetibilidad especificadas.17
No necesitamos todavía clasificar todas las posibles condiciones metrológicas. Basta retener:
\[\boxed{ \text{precisión} \text{ es una propiedad de la concordancia entre repeticiones,} }\]
no una afirmación acerca de cuán cerca estamos del valor verdadero.
Principio: la dispersión también es información
Principio 3.4 — Repetición y dispersión contienen información sobre el procedimiento Una serie de mediciones repetidas no debe reducirse a elegir un único número y descartar el resto. La localización y la dispersión de la serie describen aspectos diferentes del comportamiento del procedimiento de medición.
Este principio evita dos extremos.
Extremo A — ignorar la dispersión
Promediamos los datos y reportamos sólo
\[\bar x=2.014\,\mathrm s\]
como si la variabilidad observada no existiera.
Extremo B — tratar toda variación como fracaso
Vemos que los números no coinciden exactamente y concluimos que el experimento «salió mal».
Ambas lecturas pierden información.
El centro: media aritmética
Para una serie
\[x_1,\ldots,x_n,\]
definimos la media aritmética
\[\bar x = \frac1n \sum_{i=1}^n x_i.\]
En el ejemplo del péndulo,
\[\bar x = \frac{ 2.01+2.03+2.00+2.02+2.01 }{5} \,\mathrm s = 2.014\,\mathrm s.\]
La media resume la localización de la serie. Pero no dice por sí sola cuánto varían los datos.
Consideremos: \(A: \quad 9.99,\ 10.00,\ 10.01,\)
y
\[B: \quad 9.50,\ 10.00,\ 10.50.\]
Ambas series tienen media
\[10.00.\]
Sin embargo, la segunda está mucho más dispersa.
Por eso:
\[\boxed{ \text{media} \neq \text{descripción completa de una serie}. }\]
Desviaciones respecto de la media
Definimos las desviaciones
\[d_i=x_i-\bar x.\]
Por construcción,
\[\sum_{i=1}^n d_i = \sum_{i=1}^n(x_i-\bar x) = \sum_{i=1}^n x_i - n\bar x = 0.\]
Esta identidad explica por qué no podemos medir la dispersión simplemente sumando desviaciones con signo: las positivas y negativas se cancelan. Necesitamos una operación que no destruya la magnitud de las desviaciones.
Dos posibilidades elementales son:
usar valores absolutos;
usar cuadrados.
La estadística metrológica utiliza extensamente la segunda opción.
Rango: una primera medida de dispersión
Una medida sencilla es el rango
\[R = x_{\max}-x_{\min}.\]
Para los datos
\[2.01,\ 2.03,\ 2.00,\ 2.02,\ 2.01,\]
tenemos \(R = 2.03-2.00 = 0.03\,\mathrm s.\) El rango es intuitivo, pero utiliza sólo dos observaciones. Dos conjuntos muy distintos pueden tener el mismo rango. Por eso es útil como diagnóstico inicial, no como descripción única de la dispersión.
Desviación estándar muestral
Para una serie finita introducimos la desviación estándar muestral
\[s = \sqrt{ \frac{1}{n-1} \sum_{i=1}^n (x_i-\bar x)^2 }.\]
En este capítulo usaremos \(s\) como una medida de la dispersión observada de una muestra de mediciones repetidas. El denominador \(n-1\) no es un detalle decorativo. Aparece en el tratamiento estadístico de una muestra cuando la media se estima a partir de los mismos datos. No desarrollaremos todavía toda la teoría probabilística que lo justifica.
Para nuestros fines inmediatos debemos distinguir dos afirmaciones:
\[\boxed{ s = \text{medida de dispersión de las observaciones} }\]
y
\[\boxed{ s \neq \text{automáticamente la incertidumbre final del resultado}. }\]
Más adelante, al estudiar evaluación tipo A, veremos cómo una serie de datos contribuye a una incertidumbre estándar y por qué la incertidumbre asociada a una media no debe confundirse con la dispersión de las observaciones individuales.18
Ejemplo: calcular centro y dispersión
Volvamos a
\[2.01,\quad 2.03,\quad 2.00,\quad 2.02,\quad 2.01.\]
Ya obtuvimos
\[\bar x=2.014\,\mathrm s.\]
Las desviaciones, en segundos, son
\[-0.004,\quad 0.016,\quad -0.014,\quad 0.006,\quad -0.004.\]
La suma de cuadrados es
\[(0.004)^2 + (0.016)^2 + (0.014)^2 + (0.006)^2 + (0.004)^2 = 0.000520.\]
Entonces
\[s = \sqrt{\frac{0.000520}{4}} \,\mathrm s \approx 0.0114\,\mathrm s.\]
La pareja
\[(\bar x,s) \approx (2.014\,\mathrm s,\ 0.011\,\mathrm s)\]
resume dos características diferentes:
el centro de la serie;
su dispersión.
Todavía no estamos declarando que el resultado final de la medición sea
\[(2.014\pm0.011)\,\mathrm s.\]
Esa notación requeriría especificar qué representa el término que sigue a \(\pm\).
Precisión no es exactitud
Imaginemos ahora un instrumento que, al medir repetidamente una referencia, produce
\[9.801,\quad 9.802,\quad 9.801,\quad 9.802,\quad 9.801.\]
La dispersión es pequeña. La serie es muy precisa bajo esas condiciones. Pero supongamos que el valor de referencia relevante está próximo a
\[10.000.\]
La serie puede ser muy estrecha y, al mismo tiempo, estar desplazada respecto de la referencia. Por tanto,
\[\boxed{ \text{alta precisión} \not\Rightarrow \text{alta exactitud}. }\]
Y también puede ocurrir lo contrario: mediciones individualmente dispersas pueden distribuirse alrededor de un valor de referencia correcto. El VIM insiste en no usar precisión como sinónimo de exactitud.19
La distinción es física y lógica, no meramente terminológica.
Una analogía geométrica
Representemos resultados de medición como puntos sobre una recta.
Serie A — estrecha
\[\cdots \quad 9.99 \quad 10.00 \quad 10.01 \quad \cdots\]
Serie B — ancha
\[\cdots \quad 9.7 \quad 10.0 \quad 10.3 \quad \cdots\]
La precisión se relaciona con la anchura del agrupamiento. La exactitud, en cambio, exige comparar el agrupamiento con el valor que corresponde al mensurando dentro de un marco de referencia adecuado.
Geométricamente son preguntas distintas:
dispersión interna del conjunto;
posición del conjunto respecto de una referencia.
Esta imagen será útil cuando introduzcamos error y sesgo en §4.
Repetibilidad y condiciones
Supongamos que repetimos una medición cinco veces en pocos minutos y obtenemos una dispersión pequeña.
¿Podemos concluir que el procedimiento será igual de preciso si:
cambiamos de instrumento?;
cambia el operador?;
medimos un mes después?;
cambia la temperatura del laboratorio?;
cambiamos el procedimiento de preparación?
No. La precisión siempre está asociada a condiciones. Una serie obtenida bajo condiciones muy controladas puede describir bien la repetibilidad sin describir toda la variabilidad que aparecería bajo condiciones más amplias.
Por eso una afirmación como
«este método tiene una precisión de…»
es incompleta si no queda claro qué condiciones y qué medida de dispersión se están utilizando.
Resolución y dispersión tampoco son lo mismo
Consideremos dos casos.
Caso A — dispersión visible
Una balanza con resolución de visualización
\[0.01\,\mathrm g\]
produce
\[25.36,\quad 25.38,\quad 25.37,\quad 25.36,\quad 25.38.\]
La variación excede el simple hecho de que la pantalla esté cuantizada.
Caso B — todas las indicaciones coinciden
La misma balanza produce
\[25.37,\quad 25.37,\quad 25.37,\quad 25.37,\quad 25.37.\]
¿Significa esto dispersión física nula?
No necesariamente. La resolución puede ocultar variaciones menores que el paso visible. Por tanto,
\[\boxed{ \text{ausencia de dispersión visible} \not\Rightarrow \text{ausencia de variabilidad física}. }\]
La cuantización estudiada en §2 puede enmascarar parte de la dispersión.
Diagnóstico: tres errores frecuentes
Error 1
«Tomé muchas mediciones; por eso el resultado es exacto.»
La repetición aporta información sobre variabilidad, pero no elimina por sí sola todas las demás contribuciones.
Error 2
«Los datos están muy juntos; por eso el instrumento mide correctamente.»
Datos muy juntos indican buena precisión bajo las condiciones especificadas. No garantizan ausencia de desplazamiento sistemático.
Error 3
«La desviación estándar es la incertidumbre.»
No automáticamente. La desviación estándar de una serie describe dispersión. La incertidumbre de medición se construirá a partir de la información disponible y puede incluir múltiples contribuciones.
Práctica MA-PED
Ejercicio 3.6 — Centro y dispersión de una serie
Función pedagógica: Consolidación → Cálculo → Interpretación.
Cinco mediciones del período de un péndulo, en segundos, son \(2.01,\quad2.03,\quad2.00,\quad2.02,\quad2.01.\)
Calcula la media \(\bar x\).
Calcula el rango \(R\).
Calcula la desviación estándar muestral \(s\).
Explica qué información aporta cada cantidad.
¿Está justificado escribir sin más \((\bar x\pm s)\,\mathrm s\) como resultado final?
Solución
- La media es
\[\bar x = \frac{10.07}{5}\,\mathrm s = 2.014\,\mathrm s.\]
- El rango es
\[R=2.03-2.00=0.03\,\mathrm s.\]
- Las desviaciones son
\[-0.004,\quad0.016,\quad-0.014,\quad0.006,\quad-0.004\]
y la suma de sus cuadrados es \(0.000520\,\mathrm{s^2}.\) Por tanto,
\[s = \sqrt{\frac{0.000520}{4}} \,\mathrm s \approx 0.0114\,\mathrm s.\]
\(\bar x\) describe la localización central; \(R\) usa los extremos; \(s\) resume la dispersión de todos los datos alrededor de la media.
No sin especificar qué significado se asigna al término tras \(\pm\). En esta sección \(s\) es una medida de dispersión muestral, no una declaración completa de incertidumbre de medición.
Ejercicio 3.7 — Misma media, distinta precisión
Función pedagógica: Comparación → Diagnóstico.
Dos procedimientos producen:
\[A: \quad 10.00,\ 10.01,\ 9.99,\ 10.00,\ 10.00,\]
\[B: \quad 9.90,\ 10.10,\ 9.95,\ 10.05,\ 10.00.\]
Calcula la media de cada serie.
Compara sus rangos.
Calcula aproximadamente sus desviaciones estándar muestrales.
¿Cuál es más preciso bajo estas condiciones?
¿Puedes decidir cuál es más exacto sin información adicional?
Solución
- Ambas medias son
\[\bar x_A=\bar x_B=10.00.\]
- Los rangos son
\[R_A=10.01-9.99=0.02,\]
\[R_B=10.10-9.90=0.20.\]
- Para \(A\),
\[s_A = \sqrt{\frac{0.0002}{4}} \approx 0.0071.\]
Para \(B\), \(s_B = \sqrt{\frac{0.025}{4}} \approx 0.079.\)
\(A\) es más preciso bajo las condiciones de la comparación porque presenta mucha menor dispersión.
No. Para hablar de exactitud necesitamos información sobre el valor verdadero o una referencia metrológicamente adecuada; la dispersión interna no basta.
Ejercicio 3.8 — Muy preciso y desplazado
Función pedagógica: Contraejemplo → Distinción conceptual.
Un procedimiento aplicado repetidamente a una referencia produce \(4.98,\quad4.99,\quad4.98,\quad4.99,\quad4.98.\) Para el ejercicio, la referencia posee un valor asignado de
\[5.00\]
con una incertidumbre despreciable frente a la dispersión observada.
Describe cualitativamente la precisión de la serie.
Calcula la media.
Compara la media con el valor asignado a la referencia.
Explica por qué este ejemplo muestra que precisión y exactitud no son sinónimos.
¿Qué tipo de fenómeno conceptual anticipa la diferencia persistente respecto de la referencia?
Solución
La dispersión es pequeña; la serie es bastante precisa bajo las condiciones especificadas.
La media es
\[\bar x = \frac{24.92}{5} = 4.984.\]
- La diferencia respecto del valor asignado es
\[4.984-5.00=-0.016.\]
Las mediciones están muy juntas entre sí, pero el agrupamiento está desplazado respecto de la referencia. La precisión describe la concordancia interna; la exactitud exige otra comparación.
Anticipa la idea de una contribución sistemática o sesgo, que estudiaremos en §4. Todavía no identificamos su causa ni lo convertimos automáticamente en una corrección.
Autoexplicación: qué sabemos después de repetir
Después de una serie de mediciones podemos responder preguntas que una sola indicación no permitía:
¿dónde se concentra la serie?;
¿cuánto varían los resultados?;
¿aparecen valores atípicos?;
¿la resolución oculta parte de la variación?;
¿las condiciones de repetición están suficientemente controladas?
Pero todavía quedan preguntas abiertas:
¿existe un desplazamiento sistemático?;
¿qué diferencia hay entre error e incertidumbre?;
¿cómo incorporamos información no obtenida por repetición?;
¿qué significa una corrección de calibración?
Estas preguntas requieren una nueva distinción conceptual.
Conectar: de la dispersión al error y la incertidumbre
La repetición nos enseñó a mirar la dispersión.
Ahora debemos evitar otra confusión muy común:
\[\boxed{ \text{error} \neq \text{incertidumbre}. }\]
El siguiente paso será el §4.
Allí separaremos la diferencia —conceptual— entre un valor medido y un valor verdadero de la cuantificación de la información disponible sobre los valores atribuidos al mensurando.
4. Error, sesgo e incertidumbre
Intuir: «error» no significa simplemente «algo salió mal»
En el lenguaje cotidiano, la palabra error suele significar equivocación.
Decimos:
«Cometí un error al leer la escala.»
En metrología, sin embargo, error de medición posee un significado técnico distinto.
Supongamos que un sistema de medición produce el valor
\[x_{\mathrm m}=9.96\,\mathrm V\]
y que disponemos de un valor de referencia
\[x_{\mathrm ref}=10.00\,\mathrm V.\]
Podemos formar la diferencia
\[e = x_{\mathrm m}-x_{\mathrm ref} = -0.04\,\mathrm V.\]
Esta diferencia es un error de medición relativo a la referencia adoptada.
No significa necesariamente que alguien haya trabajado mal. El sistema puede haber sido utilizado exactamente según el procedimiento previsto y, aun así, producir una indicación desplazada.
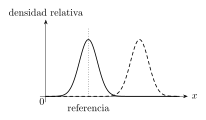
Figura 3.2. Dos distribuciones de igual anchura pueden estar centradas en lugares diferentes. La curva discontinua representa una serie desplazada respecto de la referencia. La anchura ilustra dispersión; el desplazamiento de su centro ilustra sesgo. Véase §4.
Por eso debemos separar desde el comienzo:
\[\boxed{ \text{error técnico} \neq \text{equivocación humana}. }\]
Definir: error de medición
El VIM define el error de medición como un valor medido menos un valor de referencia.20
Definición operativa 3.7 — Error de medición Dado un valor medido \(x_{\mathrm m}\) y un valor de referencia \(x_{\mathrm ref}\) apropiado para la comparación, llamaremos error de medición, en ese contexto, a
\[e=x_{\mathrm m}-x_{\mathrm ref}.\]
El error es una diferencia entre valores; no debe confundirse con la incertidumbre asociada al resultado.21
La expresión «valor de referencia apropiado» es importante.
En algunos contextos puede provenir de:
un patrón calibrado;
un valor asignado a un material de referencia;
un procedimiento de referencia;
una realización metrológica de mayor jerarquía.
El error no es una etiqueta metafísica que podamos conocer automáticamente. Si el valor de referencia también posee incertidumbre, esa información debe mantenerse en el análisis.
Un error conocido puede corregirse
Supongamos que una balanza, al medir una referencia, presenta un desplazamiento estimado de
\[b=+0.12\,\mathrm g.\]
Si interpretamos \(b\) como una estimación del error sistemático de la indicación, una corrección elemental puede escribirse
\[c=-b.\]
Para una indicación
\[m_{\mathrm{ind}}=52.48\,\mathrm g,\]
el valor corregido sería
\[m_{\mathrm{corr}} = m_{\mathrm{ind}}+c = 52.36\,\mathrm g.\]
Pero aquí aparece una idea crucial:
\[\boxed{ \text{corregir un efecto conocido} \not\Rightarrow \text{eliminar toda incertidumbre}. }\]
La propia corrección puede ser incierta. El patrón utilizado para estimarla puede tener incertidumbre. El desplazamiento puede variar con temperatura o tiempo.
Por tanto, la corrección modifica el valor atribuido, pero no convierte la medición en exacta. El VIM utiliza corrección para una compensación aplicada por un efecto sistemático estimado.22
Componentes sistemáticas y aleatorias
El VIM distingue componentes del error que se comportan de manera diferente en mediciones repetidas.23
Componente sistemática
Una componente sistemática permanece constante o varía de forma predecible bajo determinadas condiciones.
Ejemplos posibles:
desplazamiento de cero;
factor de escala incorrecto;
corrección de calibración mal aplicada;
dependencia conocida con la temperatura.
Componente aleatoria
Una componente aleatoria varía de manera no predecible entre repeticiones.
Ejemplos posibles:
ruido electrónico;
fluctuaciones de lectura;
pequeñas variaciones no controladas del procedimiento.
Esta distinción no implica que podamos observar directamente cada componente por separado. Es una estructura de análisis. Una serie muy dispersa sugiere variabilidad entre repeticiones.
Una serie muy estrecha pero desplazada respecto de una referencia puede sugerir un efecto sistemático.
Sesgo: estimar una componente sistemática
El VIM utiliza sesgo de medición (measurement bias) para una estimación del error sistemático.24
Consideremos resultados repetidos con media
\[\bar x=9.84\]
frente a una referencia
\[x_{\mathrm ref}=10.00.\]
Una estimación elemental del sesgo puede escribirse
\[\widehat b = \bar x-x_{\mathrm ref} = -0.16.\]
La notación con sombrero recuerda que estamos estimando un efecto.
No debemos confundir
\[\widehat b\]
con una cantidad conocida sin incertidumbre. Una corrección basada en ese sesgo debe transportar también la incertidumbre asociada a su estimación.
Definir: incertidumbre de medición
La incertidumbre responde a una pregunta distinta del error. El VIM la define como un parámetro no negativo que caracteriza la dispersión de los valores atribuidos al mensurando sobre la base de la información utilizada.25
Definición operativa 3.8 — Incertidumbre de medición La incertidumbre de medición es información cuantitativa que caracteriza la dispersión de los valores que pueden atribuirse razonablemente al mensurando a partir del modelo, los datos y las demás fuentes de información utilizadas. No es el error de medición ni una estimación automática de «cuánto nos equivocamos».26
Esta definición cambia el foco. El error compara dos valores. La incertidumbre caracteriza la información disponible para atribuir valores al mensurando.
Por tanto,
\[\boxed{ \text{error} \neq \text{incertidumbre}. }\]
Principio: no intercambiar error e incertidumbre
Principio 3.5 — Incertidumbre y error no son sinónimos El error expresa una diferencia respecto de un valor de referencia; la incertidumbre caracteriza la dispersión de valores atribuibles al mensurando a partir de la información disponible. Un valor de incertidumbre no debe interpretarse automáticamente como el error cometido.
Esta distinción evita expresiones frecuentes pero defectuosas como:
«El error de la medición es \(\pm0.2\,\mathrm{cm}\).»
Tal escritura puede querer decir muchas cosas:
una cota adoptada;
una incertidumbre estándar;
una incertidumbre expandida;
una tolerancia;
simplemente media división de una escala.
Sin especificar el significado, la notación no es suficiente.
Ejemplo: mismo error estimado, incertidumbres distintas
Consideremos dos procedimientos que producen el mismo valor medido: \(x_A=x_B=10.20.\)
Supongamos además que ambos se comparan con una referencia de
\[10.00.\]
Entonces la diferencia respecto de esa referencia es \(e_A=e_B=0.20.\) Pero el procedimiento A podría estar respaldado por una calibración reciente y una serie muy estable, mientras B podría usar un instrumento con deriva importante y alta variabilidad. Podríamos tener, esquemáticamente, \(u_A=0.03, \qquad u_B=0.30.\)
El error comparativo es el mismo. La incertidumbre no. De forma inversa, dos resultados pueden tener incertidumbres semejantes y errores comparativos diferentes.
Por eso son coordenadas conceptuales distintas.
Ejemplo inverso: error comparativo cero no implica incertidumbre cero
Supongamos una indicación
\[x_{\mathrm m}=10.00\]
y una referencia
\[x_{\mathrm ref}=10.00.\]
Entonces \(e=0.\)
¿Concluimos que la incertidumbre es cero?
No.
La coincidencia puede coexistir con:
resolución finita;
dispersión entre repeticiones;
incertidumbre del patrón;
correcciones imperfectamente conocidas;
efectos ambientales.
Así,
\[\boxed{ e=0 \not\Rightarrow u=0. }\]
La igualdad numérica con una referencia no elimina las limitaciones del proceso de medición.
Una advertencia sobre el «valor verdadero»
En §3 hablamos de exactitud mediante la cercanía a un valor verdadero del mensurando. Pero en una medición real ese valor no está generalmente disponible como un número conocido de forma exacta. Si estuviera perfectamente conocido, muchas mediciones perderían su propósito.
Por eso, en la práctica metrológica trabajamos con referencias, calibraciones, modelos y cadenas de trazabilidad. La frase
«el error verdadero es exactamente…»
debe utilizarse con cuidado.
Podemos calcular una diferencia respecto de una referencia.
Podemos estimar componentes sistemáticas.
Podemos evaluar incertidumbres.
No debemos fingir conocimiento que el procedimiento no proporciona.
La incertidumbre no es un intervalo mágico alrededor de la verdad
Es común escribir
\[x\pm u.\]
Pero esta notación, por sí sola, no significa:
«el valor verdadero está garantizado dentro de este intervalo».
El significado depende de qué sea \(u\). Si \(u\) es una incertidumbre estándar, se expresa con la escala de una desviación estándar. Si se utiliza una incertidumbre expandida \(U\), debe declararse el factor o la información de cobertura utilizada.
Estas ideas se formalizarán más adelante.
Por ahora fijamos una disciplina de lenguaje:
\[\boxed{ \text{símbolo }\pm \text{ sin definición} = \text{información incompleta}. }\]
Modelo de medición: dónde pueden entrar las correcciones
Supongamos un modelo elemental
\[Y=X+C,\]
donde:
\(X\) es una indicación;
\(C\) es una corrección;
\(Y\) es el valor atribuido al mensurando.
Incluso si el cálculo
\[y=x+c\]
es exacto para los números introducidos, tanto \(X\) como \(C\) pueden estar asociados a incertidumbres.
Éste será el punto de partida para §§5–7:
Diagnóstico: cuatro confusiones frecuentes
Confusión A
«Incertidumbre = error desconocido.»
Demasiado impreciso. La incertidumbre es un parámetro construido a partir de la información utilizada para caracterizar la dispersión de valores atribuidos.
Confusión B
«Si corrijo el sesgo, ya no queda incertidumbre.»
Falso. La corrección y su propia evaluación pueden contribuir a la incertidumbre.
Confusión C
«Si una medición coincide con el patrón, es exacta.»
La coincidencia observada no establece incertidumbre nula ni ausencia de otros efectos.
Confusión D
«Si conozco la incertidumbre, conozco el error.»
No en general.
Son objetos conceptuales diferentes.
Práctica MA-PED
Ejercicio 3.9 — Error comparativo, corrección e incertidumbre
Función pedagógica: Consolidación → Distinción conceptual.
Un instrumento aplicado a una referencia de
\[50.00\,\mathrm g\]
produce una media de indicaciones de
\[50.12\,\mathrm g.\]
Calcula la diferencia respecto de la referencia.
Propón una corrección elemental para compensar ese desplazamiento.
Si otra medición indica \(73.41\,\mathrm g\), calcula el valor corregido bajo ese modelo.
Explica por qué el valor corregido no debe tratarse como exacto.
Distingue en palabras: error comparativo, sesgo estimado, corrección e incertidumbre.
Solución
- La diferencia es
\[e = 50.12-50.00 = +0.12\,\mathrm g.\]
- Una corrección elemental sería
\[c=-0.12\,\mathrm g.\]
- Entonces
\[m_{\mathrm{corr}} = 73.41-0.12 = 73.29\,\mathrm g.\]
La corrección ha sido inferida a partir de una referencia y de un modelo. Puede haber incertidumbre en la referencia, variación temporal, resolución, repetibilidad y dependencia de otras condiciones.
El error comparativo es la diferencia respecto de la referencia; el sesgo estimado resume una componente sistemática inferida; la corrección es la compensación aplicada; la incertidumbre cuantifica la dispersión de valores atribuibles a partir de la información disponible.
Ejercicio 3.10 — Tres afirmaciones que parecen iguales
Función pedagógica: Diagnóstico → Contraejemplo.
Un resultado se presenta como \(x=12.4\,\mathrm{cm}, \qquad u=0.2\,\mathrm{cm}.\)
Analiza las afirmaciones:
A. «El error es exactamente \(0.2\,\mathrm{cm}\).»
B. «El valor verdadero está garantizado entre \(12.2\) y \(12.6\,\mathrm{cm}\).»
C. «La medición posee una incertidumbre declarada de \(0.2\,\mathrm{cm}\), pero debemos saber qué tipo de incertidumbre es y cómo fue evaluada para interpretar completamente el reporte.»
Decide cuál está justificada únicamente por la información dada.
Solución
A no está justificada. Un valor de incertidumbre no es automáticamente el error.
B tampoco está justificada. Sin especificar el significado de \(u\), un intervalo de cobertura o una garantía no se sigue de la notación.
C es la única formulación compatible con la información dada.
La lección es:
\[\boxed{ \text{valor de incertidumbre} \not\equiv \text{error conocido} \not\equiv \text{garantía absoluta}. }\]
Autoexplicación: un mapa conceptual
El lector debería poder reconstruir la siguiente red:
\[\text{medición repetida} \longrightarrow \text{dispersión} \longrightarrow \text{precisión},\]
mientras que
\[\text{valor medido} - \text{valor de referencia} \longrightarrow \text{error comparativo}.\]
Una componente sistemática estimada conduce a un posible
\[\text{sesgo} \longrightarrow \text{corrección},\]
y toda la información disponible contribuye a evaluar
\[\text{incertidumbre}.\]
No hay una única flecha que convierta automáticamente uno de estos conceptos en otro.
Conectar: ¿de dónde sale numéricamente una incertidumbre?
Ya sabemos qué no es la incertidumbre. Ahora necesitamos aprender a evaluarla.
Algunas contribuciones provendrán de series de datos.
Otras vendrán de:
certificados de calibración;
resolución;
especificaciones;
experiencia previa;
modelos de distribución.
Esto conduce a la distinción entre evaluaciones de tipo A y tipo B.
El siguiente paso será el §5.
5. Evaluación elemental de la incertidumbre
Intuir: una incertidumbre no aparece por decreto
En §4 distinguimos error e incertidumbre.
Ahora aparece la pregunta operativa:
¿De dónde sale numéricamente una incertidumbre?
Consideremos una medición sencilla de masa.
Podemos disponer de información procedente de fuentes muy diferentes:
una serie de indicaciones repetidas;
la resolución de la balanza;
un certificado de calibración;
una corrección por temperatura;
especificaciones del fabricante;
datos obtenidos previamente con el mismo sistema.
Todas estas piezas pueden contribuir a la incertidumbre del resultado. La evaluación no consiste en elegir «el error más grande» ni en escribir arbitrariamente
\[\pm \frac{\text{menor división}}{2}.\]
Debemos construir un modelo de medición y preguntarnos qué información poseemos sobre cada cantidad que interviene.
La estructura general será:
\[\boxed{ \text{modelo} + \text{datos} + \text{información previa} \longrightarrow \text{evaluación de incertidumbre}. }\]
El modelo de medición
Supongamos que el mensurando se representa mediante una cantidad de salida
\[Y\]
relacionada con cantidades de entrada
\[X_1,\ldots,X_N\]
por una función
\[Y=f(X_1,\ldots,X_N).\]
El VIM denomina modelo de medición a una relación matemática entre todas las magnitudes que sabemos que intervienen en una medición.27
En un caso muy simple, \(Y=X+C,\)
donde:
\(X\) es la indicación;
\(C\) es una corrección;
\(Y\) es el valor atribuido al mensurando.
En otro caso, \(\rho=\frac{m}{V},\)
donde la densidad depende de una masa y un volumen medidos. La elección de las cantidades de entrada forma parte del modelado físico. Si una variable relevante queda fuera del modelo, ninguna manipulación posterior de cifras puede recuperar automáticamente la información perdida.
Dos métodos de evaluación, no dos clases de error
La familia GUM y el VIM distinguen dos métodos de evaluación de componentes de incertidumbre:
evaluación de tipo A;
evaluación de tipo B.28
La distinción se refiere al método de evaluación.
No debemos traducirla erróneamente como
\[\text{tipo A}=\text{error aleatorio},\]
y
\[\text{tipo B}=\text{error sistemático}.\]
Tampoco significa que una evaluación tipo A sea «científica» y una tipo B sea «subjetiva».
Ambas utilizan información. La diferencia está en cómo se evalúa la componente.
Definir: evaluación tipo A
Definición operativa 3.9 — Evaluación tipo A de la incertidumbre Una evaluación tipo A es una evaluación de una componente de incertidumbre mediante análisis estadístico de valores medidos obtenidos bajo condiciones definidas.29
La situación elemental es una serie
\[x_1,\ldots,x_n.\]
Calculamos \(\bar x = \frac1n\sum_{i=1}^n x_i\)
y la desviación estándar muestral
\[s = \sqrt{ \frac{1}{n-1} \sum_{i=1}^n (x_i-\bar x)^2 }.\]
Si utilizamos la media como estimación del mensurando y las observaciones pueden tratarse, dentro del modelo adoptado, como repeticiones independientes bajo condiciones comparables, la incertidumbre estándar asociada a la media se estima mediante \(u_A(\bar x) = \frac{s}{\sqrt n}.\)
Esta fórmula no dice que la dispersión «desaparezca» al repetir.
Dice algo más específico: bajo las hipótesis estadísticas adoptadas, la incertidumbre estándar asociada a la estimación de la media disminuye como \(1/\sqrt n\). Las hipótesis importan. Si las observaciones están fuertemente correlacionadas o si el sistema deriva durante la serie, la fórmula puede dejar de representar adecuadamente la información disponible.
Ejemplo tipo A
Supongamos cuatro mediciones, en segundos, \(10.0,\quad 10.2,\quad 9.8,\quad 10.0.\) La media es \(\bar x=10.0\,\mathrm s.\) Las desviaciones son \(0,\quad0.2,\quad-0.2,\quad0,\)
y
\[s = \sqrt{ \frac{0.2^2+(-0.2)^2}{3} } \,\mathrm s = \sqrt{\frac{0.08}{3}} \,\mathrm s \approx 0.163\,\mathrm s.\]
Entonces, bajo las hipótesis anteriores,
\[u_A(\bar x) = \frac{0.163}{2}\,\mathrm s \approx 0.082\,\mathrm s.\]
Observemos la distinción: \(s\approx0.163\,\mathrm s\)
describe la dispersión de observaciones individuales, mientras
\[u_A(\bar x)\approx0.082\,\mathrm s\]
caracteriza la incertidumbre estándar asociada a la estimación de la media debida a esta fuente estadística.
Definir: evaluación tipo B
No toda información proviene de repetir mediciones.
Podemos saber, por ejemplo, que:
un certificado declara una incertidumbre;
la resolución digital es \(\Delta\);
el fabricante especifica un intervalo de tolerancia;
una corrección se conoce dentro de ciertos límites;
experiencias previas indican una dispersión plausible.
Definición operativa 3.10 — Evaluación tipo B de la incertidumbre Una evaluación tipo B es una evaluación de una componente de incertidumbre por medios distintos del análisis estadístico directo de una serie actual de valores medidos, utilizando información disponible como certificados, especificaciones, datos previos, resolución o conocimiento del sistema.30
La evaluación tipo B no significa «inventar un número razonable».
Exige declarar:
qué información se utiliza;
qué intervalo o distribución se adopta;
qué transformación convierte esa información en una incertidumbre estándar.
Definir: incertidumbre estándar
Para combinar contribuciones necesitamos expresarlas en una forma común. El VIM llama incertidumbre estándar a una incertidumbre de medición expresada como una desviación estándar.31
Definición operativa 3.11 — Incertidumbre estándar Una incertidumbre estándar es una incertidumbre de medición expresada con la escala de una desviación estándar. La denotaremos habitualmente por
\[u(x).\]
La unidad de \(u(x)\) es la misma que la de \(x\).
Si
\[x=10.0\,\mathrm V,\]
podríamos tener
\[u(x)=0.03\,\mathrm V.\]
La incertidumbre relativa, que estudiaremos después, será una cantidad de dimensión uno.
De una incertidumbre expandida a una estándar
Un certificado puede reportar una incertidumbre expandida
\[U\]
junto con un factor de cobertura
\[k.\]
En el caso elemental en que el certificado especifica
\[U=ku,\]
recuperamos la incertidumbre estándar mediante \(u=\frac{U}{k}.\) Por ejemplo, si
\[U=0.06\,\mathrm V, \qquad k=2,\]
entonces \(u=0.03\,\mathrm V.\)
No debemos escribir simplemente «\(0.06\)» en un presupuesto y combinarlo con incertidumbres estándar sin antes homogeneizar el significado de las cantidades.
Un modelo tipo B para la resolución digital
Supongamos una pantalla con paso
\[\Delta.\]
En §2 modelamos la cuantización mediante un intervalo de anchura \(\Delta\) alrededor de una indicación. Si adoptamos explícitamente el modelo de que el error de cuantización puede distribuirse uniformemente entre
\[-\frac{\Delta}{2} \quad\text{y}\quad +\frac{\Delta}{2},\]
la desviación estándar de ese modelo rectangular es \(u_{\mathrm{res}} = \frac{\Delta}{\sqrt{12}}.\) Esta identidad es una propiedad matemática de la distribución uniforme. No la derivamos aquí porque el capítulo no presupone todavía teoría de probabilidad; la utilizamos de manera explícita como parte del modelo estadístico adoptado, no como una ley física del instrumento.
Por ejemplo, para
\[\Delta=0.01\,\mathrm g,\]
obtenemos
\[u_{\mathrm{res}} = \frac{0.01}{\sqrt{12}}\,\mathrm g \approx 0.0029\,\mathrm g.\]
La fórmula no proviene de la palabra «resolución».
Proviene de dos ingredientes:
un intervalo asociado al modelo de cuantización;
una hipótesis de distribución uniforme dentro de ese intervalo.
Si cambiamos el modelo probabilístico, cambia la incertidumbre estándar asignada.
Por eso:
\[\boxed{ \text{intervalo conocido} + \text{modelo de distribución} \longrightarrow \text{incertidumbre estándar}. }\]
Por qué un intervalo no basta
Supongamos que sólo sabemos
\[-a\le X\le a.\]
Esta información fija una cota, pero no determina por sí sola una desviación estándar única.
Podríamos adoptar:
distribución uniforme;
distribución triangular;
una distribución concentrada cerca del centro;
otra distribución justificada por información física adicional.
Cada elección produce una desviación estándar diferente. Por tanto, el paso
\[\pm a \longrightarrow u\]
requiere hipótesis. La incertidumbre no es simplemente «el ancho del intervalo».
Ejemplo tipo B: certificado de calibración
Supongamos que una corrección de calibración es \(C=+0.120\,\mathrm g\)
y el certificado informa
\[U_C=0.040\,\mathrm g\]
con
\[k=2.\]
Entonces la incertidumbre estándar asociada a esa corrección es
\[u(C) = \frac{0.040}{2}\,\mathrm g = 0.020\,\mathrm g.\]
Nuestro modelo podría ser
\[Y=X+C.\]
Todavía no combinaremos \(u(X)\) y \(u(C)\).
Eso corresponde a §6. Por ahora registramos que el modelo contiene dos entradas y que cada una debe llevar consigo su propia información de incertidumbre.
Un presupuesto preliminar de incertidumbre
Antes de combinar, podemos construir una tabla conceptual:
| Entrada | Estimación | Fuente | Método de evaluación | Incertidumbre estándar |
|---|---|---|---|---|
| \(X\) | \(73.41\,\mathrm g\) | repetición | tipo A | \(u(X)\) |
| \(C\) | \(-0.12\,\mathrm g\) | certificado | tipo B | \(0.02\,\mathrm g\) |
| \(R\) | \(0\) | resolución | tipo B | \(u_{\mathrm{res}}\) |
La tercera entrada \(R\) representa aquí una corrección media nula asociada a la cuantización, pero con incertidumbre no nula. Esta forma tabular anticipa el presupuesto de incertidumbre. El objetivo no es burocrático.
La tabla obliga a declarar de dónde sale cada número.
Diagnóstico: tres confusiones frecuentes
Confusión A
«Tipo A significa aleatorio y tipo B sistemático.»
No. A y B clasifican métodos de evaluación de incertidumbre, no tipos físicos de error.
Confusión B
«Una incertidumbre tipo B es menos objetiva.»
No se sigue. Un certificado de calibración o una especificación técnica puede aportar información cuantitativa muy sólida.
Confusión C
«Si aumento indefinidamente \(n\), toda la incertidumbre tiende a cero.»
Sólo la componente modelada mediante \(s/\sqrt n\)
disminuye de esa forma bajo las hipótesis declaradas.
Las contribuciones de calibración, resolución, modelo u otras fuentes no desaparecen automáticamente al repetir la misma lectura.
Práctica MA-PED
Ejercicio 3.11 — Evaluación tipo A de una media
Función pedagógica: Cálculo → Interpretación → Hipótesis.
Cuatro mediciones de tiempo son \(10.0,\quad10.2,\quad9.8,\quad10.0\,\mathrm s.\)
Calcula \(\bar x\).
Calcula \(s\).
Bajo el modelo de repeticiones independientes en condiciones comparables, calcula
\[u_A(\bar x)=\frac{s}{\sqrt n}.\]
Explica la diferencia entre \(s\) y \(u_A(\bar x)\).
Indica una situación en la que la fórmula \(s/\sqrt n\) podría ser inadecuada.
Solución
- La media es
\[\bar x=10.0\,\mathrm s.\]
- Tenemos
\[s = \sqrt{\frac{0.08}{3}}\,\mathrm s \approx 0.163\,\mathrm s.\]
- Como \(n=4\),
\[u_A(\bar x) = \frac{0.163}{2}\,\mathrm s \approx 0.082\,\mathrm s.\]
\(s\) describe la dispersión de observaciones individuales. \(u_A(\bar x)\) es la incertidumbre estándar asociada a la estimación de la media debida a esa componente estadística bajo el modelo adoptado.
Puede ser inadecuada si existe deriva durante la serie, si las observaciones están fuertemente correlacionadas o si las condiciones cambian sistemáticamente.
Ejercicio 3.12 — Construir componentes tipo B
Función pedagógica: Clasificación → Modelización.
Para una medición de tensión disponemos de:
A. veinte lecturas repetidas tomadas en condiciones de repetibilidad;
B. un certificado que declara
\[U_{\mathrm{cal}}=0.06\,\mathrm V, \qquad k=2;\]
C. una pantalla con paso
\[\Delta=0.02\,\mathrm V,\]
cuyo error de cuantización se modela uniformemente en \([-\Delta/2,\Delta/2]\).
Clasifica cada evaluación como tipo A o tipo B.
Convierte la información del certificado en incertidumbre estándar.
Calcula la incertidumbre estándar del modelo de resolución.
Explica por qué las componentes B y C no deben llamarse simplemente «errores sistemáticos».
¿Podemos sumar todavía las tres incertidumbres estándar? Explica qué falta discutir.
Solución
A es tipo A porque utiliza análisis estadístico de la serie actual. B y C son tipo B porque utilizan otras fuentes de información y modelos.
\[u_{\mathrm{cal}} = \frac{U_{\mathrm{cal}}}{k} = \frac{0.06}{2} = 0.03\,\mathrm V.\]
\[u_{\mathrm{res}} = \frac{\Delta}{\sqrt{12}} = \frac{0.02}{\sqrt{12}} \,\mathrm V \approx 0.0058\,\mathrm V.\]
Tipo B clasifica el método de evaluación. Una componente evaluada por certificado o especificación no se identifica automáticamente con un error sistemático.
Todavía falta declarar el modelo de medición, los coeficientes de sensibilidad y las relaciones de dependencia o correlación entre entradas. La combinación pertenece a §6.
Autoexplicación: de dónde sale cada número
Ante una componente de incertidumbre debemos poder responder:
¿qué cantidad de entrada representa?;
¿qué valor se le atribuye?;
¿qué fuente de información utilizamos?;
¿la evaluación es tipo A o tipo B?;
¿cómo se obtuvo una incertidumbre estándar?;
¿qué hipótesis de distribución o de dependencia/correlación se han introducido?
Si no podemos responder estas preguntas, el número \(u=0.03\)
carece de suficiente contexto físico.
Conectar: evaluar no es todavía combinar
Después de esta sección podemos tener
\[u(x_1),\quad u(x_2),\quad \ldots,\quad u(x_N).\]
Pero el mensurando depende de esas entradas mediante \(Y=f(X_1,\ldots,X_N).\)
Necesitamos saber cómo las incertidumbres de entrada afectan a la salida.
Y antes de sumar cuadrados debemos responder una pregunta decisiva:
¿qué ocurre cuando dos entradas están correlacionadas o no podemos tratarlas como no correlacionadas?
El siguiente paso será el §6.
6. Combinación de incertidumbres
Intuir: dos incertidumbres no se suman siempre del mismo modo
En §5 terminamos con un modelo elemental de medición, \(Y=X+C+R,\)
donde cada entrada llevaba asociada una incertidumbre estándar.
Supongamos, por ejemplo,
\[u(X)=0.030\,\mathrm g, \qquad u(C)=0.020\,\mathrm g, \qquad u(R)=0.0029\,\mathrm g.\]
¿Qué incertidumbre debemos asociar al resultado \(Y\)?
Una respuesta apresurada podría ser
\[0.030+0.020+0.0029=0.0529\,\mathrm g.\]
Otra podría ser
\[\sqrt{0.030^2+0.020^2+0.0029^2} \approx 0.0362\,\mathrm g.\]
¿Cuál es correcta?
La pregunta está mal planteada si todavía no hemos declarado cómo se relacionan las contribuciones. La combinación de incertidumbres no es una regla tipográfica aplicada a una lista de números. Forma parte del modelo de medición.
Figura 3.3. Los contornos normalizados \(X^2+Y^2=1\) (continuo) y \(X^2-1{,}2XY+Y^2=0{,}64\) (discontinuo) corresponden a matrices de covarianza con correlaciones \(0\) y \(0{,}6\). Aquí \(X=\delta x/u_x\) e \(Y=\delta y/u_y\). No se les asigna un nivel de confianza. Véase §6.
Principio 3.6 — La ausencia de correlación es una hipótesis del modelo Las incertidumbres estándar pueden combinarse cuadráticamente sólo cuando las hipótesis que justifican esa combinación están declaradas. En particular, tratar dos entradas como no correlacionadas no es un automatismo: debe estar justificado por el diseño de la medición, la procedencia de los datos o el modelo adoptado.
Definir: incertidumbre estándar combinada
El VIM llama incertidumbre estándar combinada a la incertidumbre estándar obtenida a partir de las incertidumbres estándar asociadas a las cantidades de entrada de un modelo de medición.32
Definición operativa 3.12 — Incertidumbre estándar combinada La incertidumbre estándar combinada de una cantidad de salida \(Y\) es la incertidumbre estándar que resulta de propagar, a través del modelo de medición, las incertidumbres estándar y, cuando corresponda, las dependencias entre las cantidades de entrada. La denotaremos por
\[u_c(y).\]
La letra \(c\) recuerda que se trata de una incertidumbre combinada, no de una nueva clase física de error.
El caso más simple: una suma de entradas no correlacionadas
Consideremos
\[Y=X_1+X_2.\]
Supongamos que las estimaciones de entrada \(x_1\) y \(x_2\) tienen incertidumbres estándar
\[u(x_1), \qquad u(x_2),\]
y que, dentro del modelo adoptado, pueden tratarse como no correlacionadas.
Entonces la GUM conduce a
\[\boxed{ u_c(y) = \sqrt{u^2(x_1)+u^2(x_2)}. }\]
Esta regla es una suma de varianzas, seguida de una raíz cuadrada. No es una suma aritmética de incertidumbres estándar.33
Por ejemplo, si
\[u(x_1)=0.30\,\mathrm{mm}, \qquad u(x_2)=0.40\,\mathrm{mm},\]
entonces
\[u_c(y) = \sqrt{0.30^2+0.40^2}\,\mathrm{mm} = 0.50\,\mathrm{mm}.\]
La estructura recuerda al teorema de Pitágoras porque estamos combinando contribuciones cuadráticas no correlacionadas.
Resta: el signo del modelo no cambia la regla cuando no hay correlación
Sea ahora
\[Y=X_1-X_2.\]
Si las entradas son no correlacionadas, obtenemos nuevamente
\[\boxed{ u_c(y) = \sqrt{u^2(x_1)+u^2(x_2)}. }\]
El signo menos desaparece al elevar al cuadrado la contribución de \(X_2\).
Esto suele sorprender al principio. Si restamos dos números, los valores pueden cancelarse; pero la incertidumbre de cada entrada no desaparece por el mero hecho de que el modelo contenga un signo negativo.
Resultado formal: combinación lineal sin correlación
Proposición 3.2 — Combinación elemental para un modelo lineal con entradas no correlacionadas Sea
\[Y=a_1X_1+\cdots+a_NX_N,\]
donde los coeficientes \(a_i\) se consideran conocidos con incertidumbre despreciable. Si las estimaciones de entrada pueden tratarse como no correlacionadas, entonces
\[\boxed{ u_c^2(y) = \sum_{i=1}^N a_i^2u^2(x_i). }\]
En particular, \(u_c(y) = \sqrt{ \sum_{i=1}^N a_i^2u^2(x_i) }.\)
Demostración
Para un modelo lineal, una variación de entrada
\[\delta x_i\]
produce en la salida la contribución
\[\delta y_i=a_i\delta x_i.\]
La incertidumbre estándar correspondiente a esa contribución escala por el valor absoluto del coeficiente: \(u_i(y)=|a_i|u(x_i).\) Cuando las entradas son no correlacionadas, las varianzas de las contribuciones se suman. Por tanto,
\[u_c^2(y) = \sum_{i=1}^N u_i^2(y) = \sum_{i=1}^N a_i^2u^2(x_i).\]
Tomando la raíz cuadrada positiva se obtiene la segunda expresión. \(\square\)
Esta proposición es un caso especialmente limpio de la ley de propagación de incertidumbre de la GUM.34
Aplicación: completar el presupuesto de §5
Retomemos
\[Y=X+C+R.\]
Supongamos
\[X=73.41\,\mathrm g, \qquad C=-0.12\,\mathrm g, \qquad R=0,\]
con
\[u(X)=0.030\,\mathrm g, \qquad u(C)=0.020\,\mathrm g, \qquad u(R)=0.0029\,\mathrm g.\]
El valor de salida es \(y=73.29\,\mathrm g.\) Si las tres contribuciones se modelan como no correlacionadas,
\[u_c(y) = \sqrt{ 0.030^2+0.020^2+0.0029^2 }\,\mathrm g \approx 0.0362\,\mathrm g.\]
No redondearemos todavía el resultado final. La política de reporte y cifras significativas pertenece a §8.
Cuando hay dependencia: aparece la covarianza
La regla cuadrática anterior deja de ser suficiente cuando dos entradas están correlacionadas. Para dos entradas \(X_1\) y \(X_2\) en un modelo lineal
\[Y=aX_1+bX_2,\]
la expresión apropiada es
\[\boxed{ u_c^2(y) = a^2u^2(x_1) + b^2u^2(x_2) + 2ab\,u(x_1,x_2), }\]
donde
\[u(x_1,x_2)\]
representa la covarianza estimada entre las dos entradas.35
Es útil escribir
\[u(x_1,x_2) = \rho_{12}\,u(x_1)u(x_2),\]
con
\[-1\le \rho_{12}\le1.\]
Aquí \(\rho_{12}\) representa un coeficiente de correlación.
Cuando
\[\rho_{12}=0,\]
las entradas son no correlacionadas y recuperamos la regla cuadrática.
No debemos confundir:
\[\boxed{ \text{independencia} \Longrightarrow \text{no correlación} }\]
con la conversa, que no vale en general. Para este capítulo basta saber que no correlacionado es la condición que elimina el término de covarianza en la fórmula de combinación.
Ejemplo decisivo: una misma calibración puede correlacionar dos resultados
Supongamos que medimos dos longitudes con el mismo instrumento y modelamos
\[L_1=A+C,\]
\[L_2=B+C,\]
donde \(C\) representa una corrección común de calibración.
Queremos la diferencia
\[D=L_1-L_2.\]
Sustituyendo el modelo completo, \(D =(A+C)-(B+C) =A-B.\) La corrección común se cancela exactamente. Si tratáramos ingenuamente \(L_1\) y \(L_2\) como dos entradas no correlacionadas, contaríamos dos veces una contribución común que en realidad se cancela en la diferencia.
Éste es un ejemplo de por qué la correlación no es un detalle estadístico periférico. Puede cambiar cualitativamente la incertidumbre del resultado. La GUM señala precisamente que usar el mismo instrumento, patrón o dato de referencia puede introducir correlaciones significativas entre cantidades de entrada.36
Suma lineal y suma cuadrática responden a preguntas distintas
¿Por qué a veces aparece
\[u_1+u_2\]
y otras veces
\[\sqrt{u_1^2+u_2^2}?\]
Porque no representan la misma estructura. Si dos contribuciones están completamente correlacionadas con el mismo signo, pueden combinarse linealmente en el caso especial correspondiente. Si son no correlacionadas, sus varianzas se combinan cuadráticamente.
Y si lo que tenemos no son incertidumbres estándar sino cotas absolutas del tipo
\[|\delta x_1|\le a, \qquad |\delta x_2|\le b,\]
entonces una cota conservadora para la suma puede ser
\[|\delta y|\le a+b.\]
Por tanto,
\[\boxed{ \text{cota} \neq \text{incertidumbre estándar}. }\]
Mezclar ambos lenguajes produce fórmulas aparentemente contradictorias que en realidad responden a objetos matemáticos diferentes.
Producto: primera regla relativa
Consideremos ahora
\[Z=XY.\]
Perturbemos las entradas: \(X\mapsto X+\delta X, \qquad Y\mapsto Y+\delta Y.\)
Entonces
\[(X+\delta X)(Y+\delta Y) = XY +Y\delta X +X\delta Y +\delta X\delta Y.\]
Si las perturbaciones son pequeñas respecto de \(X\) e \(Y\), el término
\[\delta X\delta Y\]
es de segundo orden y puede despreciarse en una aproximación de primer orden. Así, \(\delta Z \approx Y\delta X+X\delta Y.\) Dividiendo por \(Z=XY,\)
obtenemos
\[\frac{\delta Z}{Z} \approx \frac{\delta X}{X} + \frac{\delta Y}{Y}.\]
Por ello, cuando las entradas son no correlacionadas y la aproximación de primer orden es adecuada,
\[\boxed{ \left( \frac{u_c(z)}{|z|} \right)^2 \approx \left( \frac{u(x)}{|x|} \right)^2 + \left( \frac{u(y)}{|y|} \right)^2. }\]
La GUM proporciona esta estructura para productos de potencias bajo las hipótesis correspondientes.37
Cociente: el signo cambia en la perturbación, pero no en el caso no correlacionado
Sea
\[Z=\frac{X}{Y}.\]
Para perturbaciones pequeñas,
\[\frac{X+\delta X}{Y+\delta Y} \approx \frac{X}{Y} \left( 1+ \frac{\delta X}{X} - \frac{\delta Y}{Y} \right).\]
Así,
\[\frac{\delta Z}{Z} \approx \frac{\delta X}{X} - \frac{\delta Y}{Y}.\]
Si las entradas son no correlacionadas, al combinar varianzas el signo menos desaparece y obtenemos nuevamente
\[\boxed{ \left( \frac{u_c(z)}{|z|} \right)^2 \approx \left( \frac{u(x)}{|x|} \right)^2 + \left( \frac{u(y)}{|y|} \right)^2. }\]
Si existe correlación, el signo sí importa porque afecta al término cruzado.
Ejemplo: área de una placa
Sea
\[A=LW,\]
con
\[L=1.200\,\mathrm m, \qquad u(L)=0.005\,\mathrm m,\]
\[W=0.800\,\mathrm m, \qquad u(W)=0.004\,\mathrm m.\]
El área estimada es \(A=0.960\,\mathrm{m^2}.\) Si \(L\) y \(W\) pueden tratarse como no correlacionados y la aproximación de primer orden es adecuada,
\[\frac{u_c(A)}{A} \approx \sqrt{ \left(\frac{0.005}{1.200}\right)^2 + \left(\frac{0.004}{0.800}\right)^2 } \approx 6.51\times10^{-3}.\]
Entonces
\[u_c(A) \approx 0.960\times6.51\times10^{-3}\,\mathrm{m^2} \approx 0.00625\,\mathrm{m^2}.\]
De nuevo, no hemos establecido todavía cómo debe escribirse el resultado final; eso se hará en §8.
Diagnóstico: cuatro errores plausibles
Error A — sumar todas las incertidumbres estándar
«Siempre hay que sumar \(u_1+u_2+\cdots\).»
No. Esa regla no representa el caso no correlacionado de la GUM.
Error B — aplicar siempre raíz de suma de cuadrados
«Siempre hay que usar \(\sqrt{u_1^2+u_2^2+\cdots}\).»
Tampoco. Si existen correlaciones significativas, deben incorporarse.
Error C — confundir independencia y ausencia de correlación
Para eliminar covarianzas basta la hipótesis de no correlación. La independencia es una condición más fuerte.
Error D — usar la regla relativa sin mirar el tamaño de las incertidumbres
Las fórmulas relativas de producto y cociente que acabamos de escribir son de primer orden. Si el modelo es fuertemente no lineal en la región relevante o las incertidumbres no son pequeñas, pueden ser insuficientes. Ésta será precisamente la transición a §7.
Práctica MA-PED
Ejercicio 3.13 — Sumar entradas sin sumar incertidumbres linealmente
Función pedagógica: Cálculo → Diagnóstico.
Una magnitud se modela por \(Y=X+C,\)
con
\[u(X)=0.12\,\mathrm V, \qquad u(C)=0.05\,\mathrm V.\]
Las entradas se consideran no correlacionadas.
Calcula \(u_c(Y)\).
Compara con \(0.12+0.05\).
Explica por qué ambos números no representan el mismo supuesto.
Solución
Como las entradas se modelan como no correlacionadas,
\[u_c(Y) = \sqrt{0.12^2+0.05^2}\,\mathrm V = 0.13\,\mathrm V.\]
La suma lineal sería
\[0.17\,\mathrm V.\]
No es la incertidumbre estándar combinada del modelo no correlacionado. Puede aparecer como cota conservadora en otro problema o como caso de correlación extrema con signos apropiados, pero no debe introducirse sin declarar ese modelo.
Ejercicio 3.14 — La corrección común que se cancela
Función pedagógica: Modelización → Contraejemplo.
Dos longitudes se modelan como \(L_1=A+C, \qquad L_2=B+C,\)
donde \(C\) es una corrección de calibración común. Queremos
\[D=L_1-L_2.\]
Sustituye los modelos y simplifica \(D\).
Explica por qué tratar \(L_1\) y \(L_2\) como entradas independientes puede sobrecontar la incertidumbre asociada a \(C\).
¿Qué enseñanza general deja el ejemplo sobre el presupuesto de incertidumbre?
Solución
Sustituyendo, \(D=(A+C)-(B+C)=A-B.\) La corrección común desaparece exactamente del modelo de la diferencia. Si primero construimos incertidumbres para \(L_1\) y \(L_2\) y después fingimos que ambas cantidades son independientes, perdemos la información de que comparten la misma contribución \(C\).
La enseñanza es:
\[\boxed{ \text{combinar incertidumbres exige conservar la estructura del modelo}. }\]
Ejercicio 3.15 — Producto y regla relativa
Función pedagógica: Cálculo → Hipótesis → Autoexplicación.
Una placa rectangular tiene
\[L=2.00\,\mathrm m, \qquad u(L)=0.01\,\mathrm m,\]
\[W=0.50\,\mathrm m, \qquad u(W)=0.01\,\mathrm m.\]
Supón que \(L\) y \(W\) pueden tratarse como no correlacionados y que la aproximación de primer orden es adecuada.
Calcula \(A=LW\).
Calcula \(u_c(A)/A\).
Calcula \(u_c(A)\).
Explica qué dos hipótesis hacen posible el paso de las incertidumbres de \(L\) y \(W\) a la fórmula utilizada.
Solución
El área es \(A=(2.00)(0.50)=1.00\,\mathrm{m^2}.\)
Las incertidumbres relativas son
\[\frac{u(L)}{L}=\frac{0.01}{2.00}=0.005,\]
\[\frac{u(W)}{W}=\frac{0.01}{0.50}=0.020.\]
Por tanto,
\[\frac{u_c(A)}{A} \approx \sqrt{0.005^2+0.020^2} \approx 0.0206.\]
Y
\[u_c(A) \approx 1.00\times0.0206\,\mathrm{m^2} = 0.0206\,\mathrm{m^2}.\]
Las hipótesis esenciales son:
las entradas se tratan como no correlacionadas;
la aproximación lineal de primer orden describe adecuadamente la propagación en la región de incertidumbre considerada.
Red: de la receta al modelo
El capítulo ha avanzado desde
\[\text{medir}\]
hasta
\[\text{evaluar componentes}\]
y ahora hasta
\[\text{combinar componentes}.\]
Pero la expresión general todavía está escondida detrás de los casos elementales.
En §7 haremos explícito el mecanismo matemático:
\[\boxed{ \text{modelo no lineal} \to \text{linealización local} \to \text{coeficientes de sensibilidad} \to \text{propagación}. }\]
Eso permitirá comprender cuándo las reglas de esta sección son válidas, cómo se generalizan y cuándo pueden fallar.
7. Propagación mediante linealización
Intuir: una función no lineal puede parecer lineal si miramos suficientemente cerca
En §6 aprendimos a combinar incertidumbres en modelos lineales como \(Y=a_1X_1+\cdots+a_NX_N.\)
Pero muchos modelos físicos no son lineales:
\[\rho=\frac{m}{V},\]
\[A=\pi r^2,\]
\[T=2\pi\sqrt{\frac{\ell}{g}},\]
o, más generalmente, \(Y=f(X_1,\ldots,X_N).\)
¿Cómo trasladamos entonces la incertidumbre de las entradas a la salida?
La idea matemática fundamental es local. Una función diferenciable puede aproximarse, cerca de un punto, mediante una función lineal. En una variable,
\[f(x+\delta x) = f(x) + f'(x)\,\delta x + \text{términos de orden superior}.\]
Si \(\delta x\) es suficientemente pequeño y la curvatura de \(f\) no domina en la región relevante, podemos escribir
\[\delta y \approx f'(x)\,\delta x.\]
Por tanto, la derivada no aparece aquí como un procedimiento formal aislado. Aparece porque mide cuánto cambia localmente la salida cuando cambia una entrada.
Figura 3.4. Para datos simétricos \(x=\pm a\), la media de \(x\) es cero y la de \(x^2\) vale \(a^2\). Transformar la media y promediar los valores transformados son operaciones distintas. La derivada nula en el origen no elimina esta variación de segundo orden. Véase §7.
Figura 3.5. Para \(y=x^2\), alrededor de \(x_0=1\), la tangente \(y=1+2(x-1)\) aproxima la función. El residuo exacto es \((x-1)^2\); la propagación lineal requiere una banda suficientemente pequeña. Véase §7.
Principio 3.7 — Propagar incertidumbre exige propagar también el modelo Una incertidumbre no se transporta desde las entradas a la salida mediante una regla independiente de la relación física utilizada. Debemos propagar las variaciones a través del modelo de medición y declarar el régimen en el cual su aproximación local es adecuada.
Una variable: del cambio de entrada al cambio de salida
Sea
\[Y=f(X).\]
Supongamos que utilizamos una estimación
\[x\]
para la entrada y obtenemos \(y=f(x).\) Si la entrada cambia en una pequeña cantidad \(\delta x,\)
entonces, para una función diferenciable, \(f(x+\delta x) = f(x) + f'(x)\delta x + R_2,\)
donde \(R_2\) representa los términos que la aproximación lineal omite. Si esos términos son pequeños frente al término lineal, \(\delta y \approx f'(x)\delta x.\) En términos de incertidumbre estándar, esto conduce al caso elemental
\[\boxed{ u_c(y) \approx |f'(x)|\,u(x). }\]
La barra de valor absoluto aparece porque una incertidumbre estándar es no negativa. La derivada puede ser negativa; la incertidumbre estándar no.
Definir: coeficiente de sensibilidad
En un modelo multivariable
\[Y=f(X_1,\ldots,X_N),\]
cada entrada puede influir de manera diferente sobre la salida. La GUM denomina coeficiente de sensibilidad a la derivada parcial del modelo respecto de una cantidad de entrada, evaluada en los valores utilizados para estimar la salida.38
Definición operativa 3.13 — Coeficiente de sensibilidad Para un modelo de medición
\[Y=f(X_1,\ldots,X_N),\]
definimos el coeficiente de sensibilidad asociado a la entrada \(X_i\) por
\[c_i = \left. \frac{\partial f}{\partial X_i} \right|_{X_1=x_1,\ldots,X_N=x_N}.\]
El coeficiente \(c_i\) mide, en la aproximación local de primer orden, cuánto cambia la salida cuando cambia la entrada \(X_i\). Sus unidades importan. Si
\[[Y]\]
es la unidad dimensional de la salida y
\[[X_i]\]
la de la entrada, entonces \([c_i] = \frac{[Y]}{[X_i]}.\)
Así, \(c_i\,u(x_i)\)
tiene la misma unidad que la salida. Este control dimensional es una herramienta útil para auditar una propagación.
La linealización multivariable
Sea
\[\mathbf X = (X_1,\ldots,X_N)\]
y sea
\[\mathbf x = (x_1,\ldots,x_N)\]
el punto formado por las estimaciones de entrada. Para pequeñas perturbaciones
\[\delta x_1,\ldots,\delta x_N,\]
la expansión de primer orden da
\[f(\mathbf x+\delta\mathbf x) \approx f(\mathbf x) + \sum_{i=1}^{N} c_i\,\delta x_i.\]
Por tanto,
\[\boxed{ \delta y \approx \sum_{i=1}^{N} c_i\,\delta x_i. }\]
Esta ecuación es el puente entre cálculo diferencial y propagación de incertidumbre.
No dice todavía cómo se combinan estadísticamente las contribuciones. Para eso necesitamos además la información sobre las covarianzas entre las entradas.
Resultado formal: ley de propagación de primer orden
Proposición 3.3 — Ley de propagación de incertidumbre en la aproximación lineal de primer orden Sea
\[Y=f(X_1,\ldots,X_N),\]
donde \(f\) es diferenciable en un entorno de las estimaciones
\[(x_1,\ldots,x_N).\]
Definamos
\[c_i = \left. \frac{\partial f}{\partial X_i} \right|_{\mathbf x}.\]
Si la aproximación lineal de primer orden describe adecuadamente la variación de \(f\) en la región relevante de las entradas, entonces la incertidumbre estándar combinada de la salida se aproxima por
\[\boxed{ u_c^2(y) \approx \sum_{i=1}^{N} c_i^2u^2(x_i) + 2 \sum_{i<j} c_i c_j\,u(x_i,x_j). }\]
Si las entradas pueden tratarse como no correlacionadas, \(u(x_i,x_j)=0 \qquad (i\neq j),\)
y queda
\[\boxed{ u_c^2(y) \approx \sum_{i=1}^{N} c_i^2u^2(x_i). }\]
Demostración
La linealización de primer orden produce \(\delta y \approx \sum_{i=1}^{N} c_i\,\delta x_i.\)
La varianza de una combinación lineal de contribuciones se obtiene sumando los términos diagonales y los términos cruzados:
\[u_c^2(y) \approx \sum_{i=1}^{N} c_i^2u^2(x_i) + 2 \sum_{i<j} c_i c_j\,u(x_i,x_j).\]
Si las covarianzas entre entradas distintas son nulas, \(u(x_i,x_j)=0,\)
desaparecen los términos cruzados y queda \(u_c^2(y) \approx \sum_{i=1}^{N} c_i^2u^2(x_i).\)
Tomando la raíz cuadrada positiva obtenemos \(u_c(y)\). \(\square\)
Esta es la forma local de primer orden de la ley de propagación de incertidumbre utilizada por la GUM.39
Recuperar §6 como caso particular
La proposición anterior contiene a §6.
Si
\[Y=a_1X_1+\cdots+a_NX_N,\]
entonces \(\frac{\partial Y}{\partial X_i} = a_i.\) Por tanto, \(c_i=a_i\)
y, para entradas no correlacionadas, \(u_c^2(y) = \sum_{i=1}^{N} a_i^2u^2(x_i).\) En un modelo lineal esta expresión no depende de una aproximación local de la función: la linealización coincide exactamente con el modelo. Ésta es una razón pedagógica para haber estudiado §6 antes de §7.
Ejemplo: densidad obtenida a partir de masa y volumen
Consideremos
\[\rho = \frac{m}{V}.\]
Supongamos \(m=250.0\,\mathrm g, \qquad u(m)=0.2\,\mathrm g,\)
y
\[V=100.0\,\mathrm{cm^3}, \qquad u(V)=0.5\,\mathrm{cm^3}.\]
La estimación de densidad es
\[\rho = \frac{250.0}{100.0} \,\mathrm{g/cm^3} = 2.500\,\mathrm{g/cm^3}.\]
Los coeficientes de sensibilidad son
\[c_m = \frac{\partial \rho}{\partial m} = \frac{1}{V},\]
y
\[c_V = \frac{\partial \rho}{\partial V} = -\frac{m}{V^2}.\]
Evaluados en las estimaciones, \(c_m = 0.0100\,\mathrm{cm^{-3}},\)
mientras
\[c_V = -0.0250\,\mathrm{g\,cm^{-6}}.\]
Las contribuciones estándar a la salida son
\[|c_m|u(m) = 0.0100\times0.2 \,\mathrm{g/cm^3} = 0.0020\,\mathrm{g/cm^3},\]
y
\[|c_V|u(V) = 0.0250\times0.5 \,\mathrm{g/cm^3} = 0.0125\,\mathrm{g/cm^3}.\]
Si \(m\) y \(V\) pueden tratarse como no correlacionados,
\[u_c(\rho) \approx \sqrt{ 0.0020^2+0.0125^2 } \,\mathrm{g/cm^3} \approx 0.0127\,\mathrm{g/cm^3}.\]
Este cálculo muestra algo que una mera inspección de \(u(m)\) y \(u(V)\) no mostraba: la entrada dominante es el volumen, porque el modelo amplifica más su incertidumbre en las condiciones consideradas.
Un presupuesto con coeficientes de sensibilidad
La propagación puede organizarse en una tabla:
| Entrada | Estimación | \(u(x_i)\) | \(c_i\) | \(|c_i|u(x_i)\) |
|---|---|---|---|---|
| \(m\) | \(250.0\,\mathrm g\) | \(0.2\,\mathrm g\) | \(0.0100\,\mathrm{cm^{-3}}\) | \(0.0020\,\mathrm{g/cm^3}\) |
| \(V\) | \(100.0\,\mathrm{cm^3}\) | \(0.5\,\mathrm{cm^3}\) | \(-0.0250\,\mathrm{g\,cm^{-6}}\) | \(0.0125\,\mathrm{g/cm^3}\) |
La última columna permite comparar las contribuciones ya expresadas en la escala de la salida. No basta mirar qué entrada tiene la incertidumbre numéricamente mayor. Debemos mirar qué incertidumbre produce esa entrada después de pasar por el modelo.
Forma matricial: una estructura compacta
Definamos el vector de sensibilidades
\[\mathbf c = \begin{pmatrix} c_1\\ \vdots\\ c_N \end{pmatrix}\]
y la matriz de covarianzas
\[\mathbf U = \begin{pmatrix} u^2(x_1) & u(x_1,x_2) & \cdots\\ u(x_2,x_1) & u^2(x_2) & \cdots\\ \vdots & \vdots & \ddots \end{pmatrix}.\]
Entonces la ley de propagación puede escribirse de forma compacta como
\[\boxed{ u_c^2(y) \approx \mathbf c^{\mathsf T} \mathbf U \mathbf c. }\]
Esta escritura separa limpiamente dos estructuras:
el modelo local, contenido en \(\mathbf c\);
la estructura de incertidumbre y dependencia, contenida en \(\mathbf U\).
La física entra en ambas. El modelo decide qué cantidades intervienen y cómo; el diseño experimental y la información disponible deciden qué covarianzas son relevantes.
Producto y cociente recuperados mediante derivadas
En §6 anticipamos las reglas relativas. Ahora podemos derivarlas sistemáticamente.
Sea
\[Z=XY.\]
Entonces
\[\frac{\partial Z}{\partial X}=Y, \qquad \frac{\partial Z}{\partial Y}=X.\]
Si \(X\) y \(Y\) son no correlacionadas, \(u_c^2(z) \approx y^2u^2(x) + x^2u^2(y).\)
Dividiendo por \(z^2=x^2y^2,\)
obtenemos
\[\boxed{ \left( \frac{u_c(z)}{|z|} \right)^2 \approx \left( \frac{u(x)}{|x|} \right)^2 + \left( \frac{u(y)}{|y|} \right)^2. }\]
Para
\[Z=\frac{X}{Y},\]
los coeficientes son
\[\frac{\partial Z}{\partial X} = \frac1Y,\]
\[\frac{\partial Z}{\partial Y} = -\frac{X}{Y^2}.\]
El signo desaparece al cuadrar en el caso no correlacionado, y recuperamos la misma estructura relativa.
Potencias: por qué aparece el exponente
Sea
\[Y=X^n.\]
Entonces \(\frac{dY}{dX} = nX^{n-1}.\) Por tanto, \(u_c(y) \approx |n|\,|x|^{n-1}u(x).\) Si \(x\neq0\) y \(y=x^n\),
\[\boxed{ \frac{u_c(y)}{|y|} \approx |n| \frac{u(x)}{|x|}. }\]
La regla no surge de memorizar que «el exponente baja».
Surge de la derivada del modelo. Por ejemplo, si
\[A=\pi r^2,\]
entonces \(\frac{u_c(A)}{A} \approx 2\frac{u(r)}{r}.\) Una incertidumbre relativa pequeña en el radio se amplifica aproximadamente por un factor \(2\) en el área.
¿Cuándo falla la linealización?
Hasta ahora hemos repetido una condición:
la aproximación de primer orden debe ser adecuada en la región relevante.
Debemos aprender a reconocer cuándo esta condición puede fallar.
Caso A — incertidumbre demasiado grande
Si \(u(x)\) no es pequeño comparado con la escala sobre la cual cambia apreciablemente \(f'(x)\), la curvatura de \(f\) puede importar.
Caso B — derivada casi nula
Sea
\[Y=X^2\]
cerca de
\[x=0.\]
Entonces \(f'(0)=0.\) La fórmula lineal daría
\[u_c(y)\approx0.\]
Pero si \(X\) realmente fluctúa alrededor de cero, \(X^2\) no es constante. El término cuadrático, que el primer orden descarta, es precisamente el término dominante.
Este ejemplo es decisivo:
\[\boxed{ \text{derivada nula} \not\Rightarrow \text{incertidumbre nula}. }\]
Significa que la aproximación lineal ha perdido la contribución principal.
Caso C — singularidades o fuertes no linealidades
En
\[Y=\frac1X,\]
si la región de incertidumbre de \(X\) se aproxima demasiado a cero, la función cambia violentamente y una aproximación lineal puede ser insuficiente o incluso conceptualmente inadecuada. La GUM advierte que, cuando la no linealidad es significativa en la región de incertidumbre, deben considerarse términos de orden superior o métodos más adecuados.40
La enmienda JCGM 100:2008/Amd.1:2026 — Nonlinearity in measurement models hace esta frontera todavía más explícita: una no linealidad significativa puede exigir términos de orden superior de Taylor o un método de Monte Carlo, y puede afectar no sólo la evaluación de la incertidumbre de salida, sino también la propia estimación de la salida.41
Este capítulo no desarrolla esos métodos. La conclusión operativa es más modesta y más importante:
\[\boxed{ \begin{gathered}\text{si el primer orden deja de representar}\\\text{el modelo, hay que detener la fórmula}\\\text{de primer orden.}\end{gathered} }\]
Una prueba de estrés de la aproximación
Antes de aceptar una propagación lineal conviene preguntar:
¿el modelo \(f\) es diferenciable alrededor de las estimaciones utilizadas?;
¿las incertidumbres de entrada son pequeñas respecto de las escalas características del problema?;
¿los coeficientes de sensibilidad cambian poco en la región relevante?;
¿algún coeficiente de sensibilidad es casi nulo porque estamos cerca de un extremo o punto estacionario?;
¿la región de incertidumbre se acerca a una singularidad o a un cambio abrupto del modelo?;
¿las correlaciones relevantes están representadas?
Estas preguntas no producen automáticamente una respuesta cuantitativa, pero sirven como auditoría del uso del primer orden.
Regla de control 3.7-R1 — La derivada debe ser auditada en su región de uso Evaluar una derivada en un punto no basta. La propagación lineal presupone que esa derivada representa adecuadamente el comportamiento del modelo a lo largo de la región explorada por las incertidumbres de entrada.
Práctica MA-PED
Ejercicio 3.16 — Densidad: identificar la entrada dominante
Función pedagógica: Modelo → Derivadas → Interpretación.
Para
\[\rho=\frac{m}{V},\]
se tienen
\[m=500.0\,\mathrm g, \qquad u(m)=0.5\,\mathrm g,\]
\[V=200.0\,\mathrm{cm^3}, \qquad u(V)=2.0\,\mathrm{cm^3}.\]
Supón entradas no correlacionadas.
Calcula \(\rho\).
Calcula los coeficientes de sensibilidad respecto de \(m\) y \(V\).
Calcula las dos contribuciones estándar a la salida.
Calcula \(u_c(\rho)\).
Decide qué entrada domina la incertidumbre y explica por qué no basta comparar \(0.5\) con \(2.0\).
Solución 3.16
El valor estimado es
\[\rho = \frac{500.0}{200.0} = 2.500\,\mathrm{g/cm^3}.\]
Los coeficientes son \(c_m = \frac1V = 0.00500\,\mathrm{cm^{-3}},\)
y
\[c_V = -\frac{m}{V^2} = -\frac{500.0}{200.0^2} = -0.0125\,\mathrm{g\,cm^{-6}}.\]
Las contribuciones son
\[|c_m|u(m) = 0.00500\times0.5 = 0.00250\,\mathrm{g/cm^3},\]
\[|c_V|u(V) = 0.0125\times2.0 = 0.0250\,\mathrm{g/cm^3}.\]
Por tanto,
\[u_c(\rho) \approx \sqrt{ 0.00250^2+0.0250^2 } \,\mathrm{g/cm^3} \approx 0.0251\,\mathrm{g/cm^3}.\]
La contribución del volumen domina aproximadamente por un factor \(10\).
Comparar directamente
\[0.5 \quad\text{y}\quad 2.0\]
no tiene sentido físico suficiente porque poseen unidades distintas y porque el modelo transforma cada incertidumbre con un coeficiente de sensibilidad diferente.
Ejercicio 3.17 — Una linealización que falla
Función pedagógica: Contraejemplo → Diagnóstico → Límite de método.
Considera
\[Y=X^2\]
y una estimación
\[x=0\]
con incertidumbre estándar no nula
\[u(x)=0.10.\]
Aplica mecánicamente la fórmula lineal de una variable.
Explica por qué el resultado obtenido no puede interpretarse como incertidumbre física nula de \(Y\).
Identifica qué término de la expansión de Taylor se vuelve dominante.
Formula una regla práctica para detectar situaciones semejantes.
Solución 3.17
Como \(f'(x)=2x,\)
en
\[x=0\]
tenemos \(f'(0)=0.\) La fórmula lineal produciría
\[u_c(y) \approx |f'(0)|u(x) = 0.\]
Sin embargo, \(Y=X^2\)
cambia cuando \(X\) se aparta de cero. La expansión exacta alrededor de cero es \(f(0+\delta x) = (\delta x)^2.\) El término lineal desaparece y el término cuadrático es el primer término no nulo. Por tanto, el cero obtenido no representa una ausencia real de incertidumbre: indica que la aproximación de primer orden es degenerada en ese punto.
Regla práctica:
\[\boxed{ \text{si el gradiente es nulo o muy pequeño, comprobar términos de orden superior.} }\]
Cierre: del cálculo local al reporte físico
La arquitectura construida hasta aquí es:
\[\boxed{\begin{gathered} \text{modelo de medición} \to \text{estimaciones de entrada}\\[2pt]\Downarrow\\[2pt]\text{incertidumbres y covarianzas}\\[2pt]\Downarrow\\[2pt]\text{coeficientes de sensibilidad} \to u_c(y). \end{gathered}}\]
Pero todavía falta una pregunta práctica decisiva:
¿cómo se escribe finalmente el resultado para no comunicar más información de la que realmente poseemos?
Ése será el problema de §8.
Allí estudiaremos:
redondeo de incertidumbres;
coherencia entre el redondeo de la incertidumbre y el valor reportado;
cifras significativas;
notación con incertidumbre;
falsa precisión.
El cálculo de incertidumbre no termina cuando aparece un decimal en la calculadora.
Termina cuando el resultado se comunica con una precisión compatible con la información disponible.
8. Cómo se reporta un resultado
Intuir: el cálculo no termina cuando aparece un número
Supongamos que, después de construir un modelo de medición y propagar las incertidumbres, obtenemos \(y=73.28741\,\mathrm g\)
y
\[u_c(y)=0.03617\,\mathrm g.\]
La calculadora ha terminado. La medición todavía no. Si escribimos
\[73.28741\pm0.03617\,\mathrm g,\]
hemos conservado más dígitos de los que normalmente tienen sentido en un reporte final. Si escribimos solamente
\[73.3\,\mathrm g,\]
hemos perdido la información que permite juzgar el alcance del resultado.
Reportar una medición es una operación científica: debemos conservar la información relevante y descartar la falsa precisión.
Principio 3.8 — El reporte final debe reflejar la información disponible, no la capacidad de la calculadora Durante los cálculos intermedios pueden conservarse dígitos de guarda. En el reporte final, el valor atribuido al mensurando y su incertidumbre deben redondearse de manera coherente y acompañarse de la información necesaria para interpretar qué significa la incertidumbre declarada.
La GUM recomienda precisamente evitar un número excesivo de dígitos en la estimación y en su incertidumbre, y redondear ambas de manera coherente.42
Figura 3.6. Un intervalo \(X\in[1/2,3/2]\) se transforma bajo \(Y=1/X\) en \(Y\in[2/3,2]\). Sus extremos quedan a distancias diferentes de \(Y(1)=1\). El ejemplo es un intervalo de valores admisibles, sin asignación de probabilidad. Véase §8.
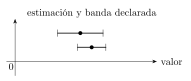
Figura 3.7. El punto es la estimación y el segmento representa el intervalo declarado. La superposición de bandas no prueba por sí sola igualdad de los valores verdaderos. Véase §8.
Dos niveles de incertidumbre que no deben confundirse
En §§5–7 hemos trabajado principalmente con incertidumbres estándar: \(u(x)\)
y con la incertidumbre estándar combinada
\[u_c(y).\]
Pero muchos certificados y reportes utilizan una incertidumbre expandida
\[U.\]
La relación típica es \(U=k\,u_c(y),\)
donde
\[k\]
es un factor de cobertura.
No debemos leer
\[y\pm U\]
como si el símbolo \(\pm\) explicara por sí solo el significado estadístico del intervalo. Para interpretar el reporte necesitamos saber, al menos, qué representa \(U\), qué valor de \(k\) se utilizó y, cuando se declara una probabilidad o nivel de cobertura, cuál es su fundamento.43
Definir: incertidumbre expandida
Definición operativa 3.14 — Incertidumbre expandida Una incertidumbre expandida es una cantidad obtenida al multiplicar una incertidumbre estándar combinada por un factor de cobertura:
\[U=k\,u_c(y).\]
Se utiliza para construir un intervalo alrededor de la estimación de salida cuando el procedimiento de evaluación y el significado de cobertura han sido especificados.44
La unidad de \(U\) es la misma que la de \(y\). Por ejemplo, si
\[u_c(y)=0.036\,\mathrm g\]
y elegimos
\[k=2,\]
entonces \(U=0.072\,\mathrm g.\) Pero el número
\[k=2\]
no significa automáticamente y sin más hipótesis «95 % exacto». La interpretación de cobertura depende de la distribución, los grados de libertad efectivos y el procedimiento utilizado. En tratamientos elementales es frecuente asociar \(k\approx2\) a una cobertura cercana al 95 % bajo condiciones aproximadamente normales y suficientemente bien justificadas, pero esa interpretación debe declararse como una aproximación, no como una identidad universal.45
Definir: factor de cobertura
Definición operativa 3.15 — Factor de cobertura El factor de cobertura \(k\) es el número por el cual se multiplica la incertidumbre estándar combinada para obtener una incertidumbre expandida:
\[U=k\,u_c(y).\]
Su valor debe acompañar el reporte cuando se utiliza \(U\), salvo que el contexto documental ya lo defina inequívocamente.46
Esta definición separa dos objetos: \(u_c(y) \qquad\text{y}\qquad U.\)
No podemos sumar o comparar directamente incertidumbres estándar e incertidumbres expandidas sin antes llevarlas a una escala común.
La notación \(\pm\) no tiene una semántica universal
Consideremos
\[L=(24.60\pm0.05)\,\mathrm{cm}.\]
¿Qué significa
\[0.05\,\mathrm{cm}?\]
Podría representar:
una incertidumbre estándar;
una incertidumbre expandida;
una semiamplitud de un intervalo de tolerancia;
una cota conservadora;
la mitad de una resolución instrumental;
otra convención definida por quien reporta.
La escritura por sí sola no decide.
Por tanto:
\[\boxed{ \pm \ \text{es una notación, no una teoría de incertidumbre}. }\]
Un reporte científicamente interpretable debe declarar qué significa el número que sigue al símbolo. Por ejemplo, una forma clara es \(m=(73.290\pm0.072)\,\mathrm g,\)
seguida de
donde \(0.072\,\mathrm g\) es la incertidumbre expandida \(U\) obtenida con \(k=2\).
Si además se atribuye una probabilidad de cobertura, debe explicarse cómo se obtuvo.47
Cifras significativas y posiciones decimales
Dos conceptos se confunden con frecuencia:
cifras significativas;
posición decimal.
El número \(0.036\)
tiene dos cifras significativas: \(3,\ 6.\) Su última cifra está en la posición de las milésimas. El número \(73.290\)
tiene cinco cifras significativas y termina también en la posición de las milésimas. Esta coincidencia de posición decimal es precisamente lo que buscamos cuando reportamos
\[y=73.290\,\mathrm g, \qquad u_c(y)=0.036\,\mathrm g.\]
La incertidumbre determina qué posiciones del valor reportado siguen siendo informativas en el formato final. Eso no significa que el número de cifras significativas de una medición pueda inferirse únicamente mirando el instrumento. Tampoco significa que cada dígito de una expansión decimal tenga idéntica significación física.
Regla editorial del tratado para el redondeo final
Adoptaremos la siguiente política editorial para los ejemplos de este tratado.
Durante los cálculos intermedios, conservaremos suficientes dígitos de guarda para evitar que el redondeo temprano domine el resultado.
En el reporte final, la incertidumbre se expresará normalmente con dos cifras significativas.
El valor atribuido al mensurando se redondeará hasta la misma posición decimal que la incertidumbre reportada.
Si existe una razón metrológica o numérica para conservar más cifras, se declarará explícitamente.
Si se utiliza incertidumbre expandida, se reportará el factor de cobertura \(k\) y, cuando corresponda, el significado de cobertura.
Esta política es una convención editorial coherente con la recomendación general de la GUM de no reportar un número excesivo de dígitos; no debe confundirse con una ley matemática que obligue siempre a usar exactamente dos cifras significativas.48
Ejemplo: de los dígitos de cálculo al reporte
Retomemos
\[y=73.28741\,\mathrm g\]
y
\[u_c(y)=0.03617\,\mathrm g.\]
Primero redondeamos la incertidumbre estándar a dos cifras significativas: \(u_c(y)\approx0.036\,\mathrm g.\) La última cifra está en milésimas de gramo. Por tanto, redondeamos el valor a la misma posición: \(y\approx73.287\,\mathrm g.\)
El formato preferente de este tratado para una incertidumbre estándar será mantener separados el valor atribuido y su incertidumbre:
\[\boxed{ m=73.287\,\mathrm g, \qquad u_c(m)=0.036\,\mathrm g. }\]
La GUM enumera también formas compactas con \(\pm u_c\), pero recomienda evitar ese formato siempre que sea posible porque el símbolo \(\pm\) se asocia tradicionalmente con intervalos de alta cobertura y puede confundirse con una incertidumbre expandida.49
Por tanto, si excepcionalmente se utiliza
\[m=(73.287\pm0.036)\,\mathrm g,\]
debe declararse de forma inmediata que
\[0.036\,\mathrm g=u_c(m)\]
y que no se está afirmando por ello un intervalo expandido ni una probabilidad de cobertura. Si elegimos una incertidumbre expandida con
\[k=2,\]
entonces, antes de redondear, \(U = 2(0.03617)\,\mathrm g = 0.07234\,\mathrm g.\)
Reportamos
\[U\approx0.072\,\mathrm g\]
y, de nuevo, redondeamos el valor a milésimas:
\[\boxed{ m=(73.287\pm0.072)\,\mathrm g, \qquad k=2. }\]
El valor central no debe cambiar arbitrariamente de precisión entre dos reportes equivalentes.
No redondear demasiado pronto
Supongamos que debemos calcular
\[Q=abc\]
a partir de tres valores medidos. Si redondeamos agresivamente cada resultado intermedio, el error numérico introducido por nuestras propias operaciones puede llegar a ser comparable con la incertidumbre que intentamos evaluar.
Por eso distinguimos:
\[\boxed{ \text{dígitos de trabajo} \neq \text{dígitos de reporte}. }\]
Los dígitos de trabajo existen para proteger el cálculo.
Los dígitos de reporte existen para comunicar la información físicamente justificada.
Esta separación evita dos extremos:
redondear demasiado pronto;
publicar todos los dígitos internos de la calculadora.
Un cero final puede contener información
Comparemos
\[12\,\mathrm{cm},\]
\[12.0\,\mathrm{cm},\]
y
\[12.00\,\mathrm{cm}.\]
Como números reales escritos en notación decimal ordinaria representan el mismo valor numérico: \(12=12.0=12.00.\) Pero en un reporte de medición pueden comunicar distinto nivel de redondeo. Si, por ejemplo, el contexto define explícitamente que \(0.03\,\mathrm{cm}\) es una incertidumbre expandida y escribimos
\[L=(12.00\pm0.03)\,\mathrm{cm},\]
el cero final ayuda a mostrar que el valor se ha reportado hasta centésimas de centímetro. Sin embargo, no debemos inferir la incertidumbre completa a partir del número de decimales: \(12.00\,\mathrm{cm}\)
por sí solo no nos dice si la incertidumbre es
\[0.01\,\mathrm{cm}, \quad 0.03\,\mathrm{cm}, \quad 0.20\,\mathrm{cm},\]
u otro valor. La incertidumbre debe declararse o estar definida por el contexto documental.
Notación científica y coherencia
Para cantidades muy grandes o muy pequeñas, la notación científica puede hacer más visible la estructura del reporte. Por ejemplo, \(R = (1.234\pm0.006)\times10^6\,\Omega\)
es preferible a escribir una larga cadena de ceros si esa forma facilita la comparación entre valor e incertidumbre.
Podemos factorizar la potencia de diez porque afecta por igual al valor y a la incertidumbre:
\[(1.234\pm0.006)\times10^6 = 1.234\times10^6 \pm 0.006\times10^6.\]
El control dimensional sigue siendo obligatorio: \([y]=[u_c(y)]=[U].\) Una incertidumbre absoluta sin unidad, cuando la salida sí tiene dimensión física, es una señal inmediata de error de reporte.
Cifras significativas no equivalen a incertidumbre
Una regla escolar frecuente dice algo como:
«el número de cifras significativas indica la precisión de la medida».
Como primera intuición puede servir para advertir contra la falsa precisión, pero es demasiado imprecisa para un tratamiento metrológico.
Un reporte completo debe distinguir:
Dos resultados pueden tener el mismo número de cifras significativas y, sin embargo, incertidumbres muy diferentes. Y dos resultados con distinta cantidad de dígitos impresos pueden representar la misma calidad metrológica si utilizan unidades o escalas diferentes.
Por tanto:
\[\boxed{ \text{cifras significativas} \not\equiv \text{incertidumbre de medición}. }\]
Plantilla mínima de reporte
Para este tratado utilizaremos tres niveles de reporte.
Nivel A — incertidumbre estándar
El formato canónico y preferente del tratado será
\[\boxed{ Y=y, \qquad u_c(y)=u. }\]
La forma \(Y=(y\pm u)\,[Y]\)
está contemplada por la GUM si se identifica expresamente \(u\) como incertidumbre estándar combinada, pero aquí no será el formato ordinario porque puede confundirse con un intervalo expandido.50
Nivel B — incertidumbre expandida
\[\boxed{ Y=(y\pm U)\,[Y], \qquad U=k\,u_c(y), \qquad k=\text{valor declarado}. }\]
Nivel C — reporte metrológico completo
Además de lo anterior se incluyen, según corresponda:
definición del mensurando;
modelo de medición;
principales componentes de incertidumbre;
método de evaluación;
factor de cobertura;
nivel o probabilidad de cobertura y su fundamento;
condiciones experimentales relevantes;
trazabilidad o referencias documentales.
La GUM y NIST insisten en que el resultado debe ir acompañado por información suficiente para reconstruir el significado de la incertidumbre declarada.5152
Diagnóstico: cuatro errores de reporte
Error A — copiar todos los dígitos de la calculadora
\[x=2.483746192\,\mathrm m\]
cuando
\[u(x)=0.03\,\mathrm m.\]
Los últimos dígitos no están respaldados por la incertidumbre.
Error B — redondear la incertidumbre pero no el valor
\[x=2.483746192\,\mathrm m, \qquad u(x)=0.03\,\mathrm m.\]
El valor central debe redondearse de manera coherente: \(x=2.48\,\mathrm m, \qquad u(x)=0.03\,\mathrm m.\)
Error C — escribir \(\pm\) sin explicar su significado
\[x=(2.48\pm0.03)\,\mathrm m\]
es incompleto si no sabemos qué representa \(0.03\,\mathrm m\).
Error D — atribuir una probabilidad universal a \(k=2\)
No podemos escribir automáticamente
«\(k=2\) significa exactamente 95 %»
sin declarar el modelo y el fundamento de cobertura.
Práctica MA-PED
Ejercicio 3.18 — Convertir un cálculo en un reporte
Función pedagógica: Cálculo → Redondeo → Interpretación.
Un procedimiento produce \(y=18.37642\,\mathrm V\)
y
\[u_c(y)=0.08473\,\mathrm V.\]
Reporta \(u_c(y)\) con dos cifras significativas.
Redondea \(y\) de manera coherente.
Escribe el reporte preferente del tratado para la incertidumbre estándar combinada y explica por qué no usaremos normalmente \(\pm u_c\) como formato principal.
Si se adopta \(k=2\), calcula y reporta la incertidumbre expandida.
- Solución
- Dos cifras significativas:
\[u_c(y) \approx 0.085\,\mathrm V.\]
- La última cifra de la incertidumbre está en milésimas de volt:
\[y \approx 18.376\,\mathrm V.\]
- El reporte preferente es
\[\boxed{ y=18.376\,\mathrm V, \qquad u_c(y)=0.085\,\mathrm V. }\]
La forma compacta
\[y=(18.376\pm0.085)\,\mathrm V\]
requeriría aclarar inmediatamente que \(0.085\,\mathrm V\) es \(u_c(y)\). No la utilizamos como formato principal porque \(\pm\) puede confundirse con la notación habitual de una incertidumbre expandida.
- Antes del redondeo final,
\[U = 2(0.08473)\,\mathrm V = 0.16946\,\mathrm V.\]
Con dos cifras significativas, \(U\approx0.17\,\mathrm V.\) La última cifra está en centésimas, de modo que
\[y\approx18.38\,\mathrm V.\]
Un reporte expandido coherente es
\[\boxed{ y=(18.38\pm0.17)\,\mathrm V, \qquad k=2. }\]
El cambio en la cantidad de decimales del valor central no representa un cambio físico del resultado; responde a la escala de la incertidumbre que estamos reportando.
Ejercicio 3.19 — ¿Qué significa realmente el símbolo \(\pm\)?
Función pedagógica: Diagnóstico → Contraejemplo → Comunicación.
Se encuentran tres reportes:
\[A=(5.40\pm0.05)\,\mathrm{cm},\]
\[B=(5.40\pm0.05)\,\mathrm{cm},\]
\[C=(5.40\pm0.05)\,\mathrm{cm}.\]
En el informe de \(A\), \(0.05\,\mathrm{cm}\) es una incertidumbre estándar combinada. En el informe de \(B\), \(0.05\,\mathrm{cm}\) es una incertidumbre expandida con \(k=2\). En el informe de \(C\), \(0.05\,\mathrm{cm}\) es sólo la semiamplitud de una tolerancia especificada.
¿Son metrológicamente equivalentes los tres reportes?
¿Qué información adicional necesita cada uno?
Explica por qué la notación \(\pm\) no basta para identificar la incertidumbre.
- Solución
No. La expresión impresa es idéntica, pero los números que siguen a \(\pm\) representan objetos diferentes.
Para \(A\) debe declararse que se trata de
\[u_c(A)=0.05\,\mathrm{cm}.\]
Para \(B\) debe declararse
\[U=0.05\,\mathrm{cm}, \qquad k=2,\]
y, si se asigna una probabilidad de cobertura, debe indicarse su fundamento. Para \(C\) debe indicarse que
\[0.05\,\mathrm{cm}\]
es una tolerancia o cota, no una incertidumbre estándar. Si se quisiera convertirla en una incertidumbre estándar sería necesario añadir un modelo probabilístico o una regla de evaluación justificable.
- El símbolo
\[\pm\]
sólo expresa una forma simétrica de escritura alrededor de un valor central. La semántica del número asociado proviene del procedimiento de medición y del reporte, no del símbolo.
Red: lo que debe sobrevivir al cálculo
El flujo completo de §§5–8 puede resumirse como
\[\boxed{\begin{gathered} \text{fuentes de información} \to \text{incertidumbres estándar}\\[2pt]\Downarrow\\[2pt]\text{modelo} \to \text{propagación}\\[2pt]\Downarrow\\[2pt]u_c(y) \to \text{decisión de cobertura}\\[2pt]\Downarrow\\[2pt]\text{reporte}. \end{gathered}}\]
Cada flecha añade estructura. El resultado final no es simplemente «el número al que llegó la cuenta». Es una afirmación cuantitativa cuyo alcance puede ser interpretado por otra persona.
En §9 introduciremos la incertidumbre relativa, que permitirá comparar resultados de escalas muy diferentes sin perder de vista la diferencia entre incertidumbre absoluta y relativa.
9. Incertidumbre relativa y comparación de escalas
Intuir: la misma incertidumbre absoluta puede significar cosas muy diferentes
Comparemos dos resultados:
\[L_1=100.0\,\mathrm{cm}, \qquad u(L_1)=0.1\,\mathrm{cm},\]
y
\[L_2=1.0\,\mathrm{cm}, \qquad u(L_2)=0.1\,\mathrm{cm}.\]
En ambos casos la incertidumbre estándar absoluta es la misma: \(0.1\,\mathrm{cm}.\) Pero su importancia física no es la misma. En el primer caso representa una parte pequeña del valor medido; en el segundo, una fracción mucho mayor. La comparación natural no es entonces sólo
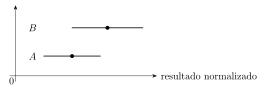
Figura 3.8. Los dos intervalos dibujados se solapan. Ese hecho geométrico no equivale por sí solo a una prueba de compatibilidad estadística: hacen falta el significado de las barras, las correlaciones y el criterio declarado. Véase §9.
\[u(L_1) \quad\text{frente a}\quad u(L_2),\]
sino
\[\frac{u(L_1)}{|L_1|} \quad\text{frente a}\quad \frac{u(L_2)}{|L_2|}.\]
Obtenemos \(\frac{0.1}{100.0}=0.001\)
y
\[\frac{0.1}{1.0}=0.1.\]
Es decir, \(0.1\%\)
frente a
\[10\%.\]
La incertidumbre absoluta responde a la pregunta
¿cuál es la escala de variación expresada en las unidades de la magnitud?
La incertidumbre relativa responde a otra:
¿qué fracción del tamaño del valor estimado representa esa incertidumbre?
Ambas preguntas son legítimas. No son intercambiables.
Definir: incertidumbre estándar relativa
La GUM utiliza la incertidumbre estándar relativa como el cociente entre una incertidumbre estándar y el valor absoluto de la estimación correspondiente, siempre que esa estimación no sea cero.53
Definición operativa 3.16 — Incertidumbre estándar relativa Sea una estimación no nula
\[x\neq0\]
con incertidumbre estándar
\[u(x).\]
Definimos su incertidumbre estándar relativa por
\[\boxed{ u_r(x) = \frac{u(x)}{|x|}. }\]
Es una cantidad adimensional. Puede expresarse como fracción, porcentaje o, cuando resulte útil, en partes por millón u otra escala adimensional equivalente. La barra de valor absoluto garantiza que
\[u_r(x)\ge0.\]
Por ejemplo, si
\[x=250.0\,\mathrm g, \qquad u(x)=0.5\,\mathrm g,\]
entonces \(u_r(x) = \frac{0.5}{250.0} = 0.002 = 0.2\%.\)
Una cantidad adimensional no significa una cantidad sin interpretación
Como \([u(x)]=[x],\)
el cociente
\[\frac{u(x)}{|x|}\]
no tiene dimensión física. Pero que sea adimensional no significa que carezca de significado. El valor
\[0.002\]
puede leerse como \(2\times10^{-3},\)
como \(0.2\%,\)
o como \(2000\ \text{partes por millón}.\)
Son distintas escalas de presentación para la misma razón adimensional. La elección depende del contexto.
La incertidumbre relativa es invariante ante un cambio exacto de unidad
Supongamos que cambiamos de unidad mediante un factor exacto
\[a\neq0.\]
Entonces \(x'=ax.\)
Como \(a\) es exacto, \(u(x')=|a|u(x).\) Por tanto,
\[u_r(x') = \frac{u(x')}{|x'|} = \frac{|a|u(x)}{|a||x|} = \frac{u(x)}{|x|}.\]
Así,
\[\boxed{ u_r(x')=u_r(x).}\]
Si una longitud se expresa en metros o centímetros mediante una conversión exacta, su incertidumbre absoluta cambia numéricamente con la unidad, pero su incertidumbre relativa no. Por ejemplo, \(L=1.000\,\mathrm m, \qquad u(L)=0.001\,\mathrm m\)
se convierte en
\[L=100.0\,\mathrm{cm}, \qquad u(L)=0.1\,\mathrm{cm},\]
y en ambos casos
\[u_r(L)=0.001.\]
Esta invariancia hace especialmente útil a la incertidumbre relativa para comparar escalas.
Comparar instrumentos y procedimientos
Supongamos dos procedimientos para medir longitudes distintas:
| Resultado | Incertidumbre estándar | Incertidumbre relativa |
|---|---|---|
| \(L_A=2.000\,\mathrm m\) | \(u(L_A)=0.002\,\mathrm m\) | \(0.1\%\) |
| \(L_B=20.0\,\mathrm{mm}\) | \(u(L_B)=0.1\,\mathrm{mm}\) | \(0.5\%\) |
Mirando sólo las incertidumbres absolutas, \(0.002\,\mathrm m\)
y
\[0.1\,\mathrm{mm}\]
no pueden compararse de manera informativa sin considerar las escalas de las magnitudes. Al normalizar, \(u_r(L_A)=0.001,\)
mientras
\[u_r(L_B)=0.005.\]
En relación con el tamaño de lo medido, el primer resultado tiene una incertidumbre relativa menor. Pero esta comparación tiene un límite conceptual importante: una incertidumbre relativa menor no convierte automáticamente un procedimiento en «mejor» en todos los sentidos. La adecuación depende también del mensurando, el intervalo de trabajo, los sesgos, la trazabilidad, la resolución necesaria y el propósito de la medición.
El problema del cero
La definición
\[u_r(x)=\frac{u(x)}{|x|}\]
requiere
\[x\neq0.\]
Si
\[x=0,\]
el cociente no está definido. Y si
\[x\]
es muy pequeño comparado con
\[u(x),\]
la incertidumbre relativa puede hacerse muy grande. Por ejemplo, \(x=0.002\,\mathrm V, \qquad u(x)=0.010\,\mathrm V\)
da \(u_r(x)=5=500\%.\)
No hay ninguna contradicción matemática. El resultado nos está diciendo que la escala de la incertidumbre es varias veces mayor que el valor estimado. Sin embargo, en problemas donde el valor de interés puede atravesar cero, la incertidumbre relativa puede dejar de ser una forma estable o útil de resumen.
Prueba de estrés — No dividir mecánicamente por un valor cercano a cero La incertidumbre relativa es una normalización por \(|x|\). Si \(x\) es cero no está definida; si \(|x|\) es muy pequeño, puede amplificar enormemente la razón. En esos casos debe conservarse la incertidumbre absoluta y analizarse el problema físico antes de interpretar porcentajes.
De §7 a una regla relativa para productos
En §7 obtuvimos, para
\[Z=XY,\]
con entradas no correlacionadas, \(u_c^2(z) \approx y^2u^2(x)+x^2u^2(y).\)
Si
\[z=xy\neq0,\]
dividimos por \(z^2=x^2y^2\)
y obtenemos
\[\left(\frac{u_c(z)}{|z|}\right)^2 \approx \left(\frac{u(x)}{|x|}\right)^2 + \left(\frac{u(y)}{|y|}\right)^2.\]
Es decir,
\[\boxed{ u_r^2(z) \approx u_r^2(x)+u_r^2(y) }\]
bajo las hipótesis declaradas. La aparente simplicidad de esta expresión no debe ocultar su origen: es la ley de propagación de primer orden aplicada a un modelo multiplicativo.
Potencias: el exponente amplifica la incertidumbre relativa
Sea
\[Y=X^a\]
en una región donde la función sea diferenciable y
\[x\neq0.\]
Entonces \(\frac{\partial Y}{\partial X} = aX^{a-1}.\) La propagación de primer orden da \(u_c(y) \approx |a|\,|x|^{a-1}u(x)\)
en el caso real donde la expresión esté bien definida.
Como \(|y|=|x^a|,\)
obtenemos, localmente,
\[\boxed{ u_r(y) \approx |a|\,u_r(x).}\]
Así, para un cuadrado, \(u_r(x^2) \approx 2u_r(x),\)
y para una raíz cuadrada, \(u_r(\sqrt{x}) \approx \frac12u_r(x),\)
siempre dentro del régimen donde la linealización sea adecuada.
Resultado formal: monomios y propagación relativa
Proposición 3.4 — Propagación relativa de primer orden en un modelo monomial Considérese
\[Z = C\prod_{i=1}^{N}X_i^{a_i},\]
donde \(C\neq0\) es exacta, los exponentes \(a_i\) son constantes y el modelo es diferenciable en un entorno de las estimaciones no nulas
\[x_i\neq0.\]
Si la aproximación lineal de primer orden es adecuada, entonces
\[\boxed{ \frac{u_c^2(z)}{z^2} \approx \sum_{i=1}^{N} a_i^2\frac{u^2(x_i)}{x_i^2} + 2\sum_{i<j} a_i a_j \frac{u(x_i,x_j)}{x_ix_j}. }\]
Si además las entradas pueden tratarse como no correlacionadas, \(u(x_i,x_j)=0 \qquad(i\neq j),\)
entonces
\[\boxed{ u_r^2(z) \approx \sum_{i=1}^{N} a_i^2u_r^2(x_i). }\]
Demostración
Para
\[Z = C\prod_{i=1}^{N}X_i^{a_i},\]
la derivada parcial respecto de \(X_i\) es
\[\frac{\partial Z}{\partial X_i} = a_i\frac{Z}{X_i}.\]
Por tanto, el coeficiente de sensibilidad evaluado en las estimaciones es \(c_i = a_i\frac{z}{x_i}.\) Sustituyendo en la proposición 3.3,
\[u_c^2(z) \approx \sum_i \left(a_i\frac{z}{x_i}\right)^2u^2(x_i) + 2\sum_{i<j} \left(a_i\frac{z}{x_i}\right) \left(a_j\frac{z}{x_j}\right) u(x_i,x_j).\]
Factorizando \(z^2\),
\[u_c^2(z) \approx z^2 \left[ \sum_i a_i^2\frac{u^2(x_i)}{x_i^2} + 2\sum_{i<j} a_i a_j\frac{u(x_i,x_j)}{x_ix_j} \right].\]
Como \(z\neq0\), dividimos por \(z^2\) y obtenemos la primera fórmula. Si las covarianzas entre entradas distintas son nulas, desaparecen los términos cruzados y queda
\[\frac{u_c^2(z)}{z^2} \approx \sum_i a_i^2\frac{u^2(x_i)}{x_i^2}.\]
Por la definición definición 3.16,
\[u_r^2(z) \approx \sum_i a_i^2u_r^2(x_i). \qquad\square\]
La GUM presenta esta forma relativa para productos de potencias como consecuencia de la ley de propagación bajo las hipótesis correspondientes.54
Ejemplo: densidad y contribuciones relativas
Para
\[\rho=\frac{m}{V},\]
los exponentes son \(a_m=1, \qquad a_V=-1.\) Si masa y volumen son no correlacionados, \(u_r^2(\rho) \approx u_r^2(m)+u_r^2(V).\) Tomemos
\[m=250.0\,\mathrm g, \qquad u(m)=0.2\,\mathrm g,\]
y
\[V=100.0\,\mathrm{cm^3}, \qquad u(V)=0.5\,\mathrm{cm^3}.\]
Entonces
\[u_r(m) = \frac{0.2}{250.0} = 8.0\times10^{-4} = 0.08\%,\]
mientras
\[u_r(V) = \frac{0.5}{100.0} = 5.0\times10^{-3} = 0.50\%.\]
Por tanto,
\[u_r(\rho) \approx \sqrt{ (8.0\times10^{-4})^2 + (5.0\times10^{-3})^2 } \approx 5.06\times10^{-3}.\]
Es decir, \(u_r(\rho)\approx0.51\%.\) La comparación relativa muestra inmediatamente que la contribución del volumen domina el presupuesto.
¿Cuándo conviene usar incertidumbre absoluta y cuándo relativa?
No existe una regla que obligue a elegir una sola representación. La incertidumbre absoluta
\[u(x)\]
es indispensable porque conserva la escala y la unidad física de la magnitud. La incertidumbre relativa
\[u_r(x)\]
es especialmente útil para:
comparar resultados de escalas muy diferentes;
analizar productos, cocientes y potencias;
identificar contribuciones dominantes en términos porcentuales;
expresar especificaciones proporcionales;
comparar el rendimiento relativo de procedimientos cuando esa comparación es físicamente pertinente.
Una buena práctica es conservar ambas cuando aportan información distinta. Por ejemplo,
\[x=12.000\,\mathrm V, \qquad u(x)=0.006\,\mathrm V,\]
contiene información de escala que no aparece en
\[u_r(x)=0.0005=0.05\%.\]
Y el porcentaje permite una comparación que la cifra
\[0.006\,\mathrm V\]
por sí sola no ofrece.
Espacio de ejemplos y no-ejemplos
Ejemplo A — Comparación legítima
Dos masas:
\[m_1=100.0\,\mathrm g, \qquad u(m_1)=0.2\,\mathrm g,\]
\[m_2=10.00\,\mathrm g, \qquad u(m_2)=0.05\,\mathrm g.\]
Entonces \(u_r(m_1)=0.2\%, \qquad u_r(m_2)=0.5\%.\) La segunda medición tiene mayor incertidumbre relativa aunque su incertidumbre absoluta sea menor.
No-ejemplo B — Dividir por cero
Si
\[x=0,\]
no escribimos
\[u_r(x)=\frac{u(x)}{0}.\]
La incertidumbre relativa no está definida.
No-ejemplo C — Confundir porcentaje con probabilidad
Si
\[u_r(x)=2\%,\]
esto no significa que exista una «probabilidad del 98 % de que el valor sea correcto». El 2 % expresa una razón entre la incertidumbre estándar y la magnitud de la estimación. No es, por sí mismo, una probabilidad de cobertura.
Ejercicio 3.20 — Misma incertidumbre absoluta, distinta escala. 3.20 Se obtienen dos longitudes:
\[L_A=50.0\,\mathrm{cm}, \qquad u(L_A)=0.2\,\mathrm{cm},\]
y
\[L_B=5.00\,\mathrm{cm}, \qquad u(L_B)=0.2\,\mathrm{cm}.\]
Calcula las incertidumbres estándar relativas.
Exprésalas en porcentaje.
Explica por qué la igualdad de las incertidumbres absolutas no implica igual calidad relativa.
Solución ejercicio 3.20 Para \(L_A\),
\[u_r(L_A) = \frac{0.2}{50.0} = 0.004 = 0.4\%.\]
Para \(L_B\), \(u_r(L_B) = \frac{0.2}{5.00} = 0.04 = 4\%.\) Aunque ambas incertidumbres absolutas valen \(0.2\,\mathrm{cm}\), en el segundo resultado esa escala representa una fracción diez veces mayor del valor medido. Por ello la comparación relativa distingue situaciones que la incertidumbre absoluta, aislada, no distingue.
Ejercicio 3.21 — Una ley de potencias. 3.21 Una magnitud se modela por
\[Q = C\frac{A^2B}{D^3},\]
donde \(C\) es exacta y \(A\), \(B\) y \(D\) pueden tratarse como no correlacionadas. Se conocen
\[u_r(A)=1.0\%, \qquad u_r(B)=2.0\%, \qquad u_r(D)=0.5\%.\]
Calcula la incertidumbre estándar relativa aproximada de \(Q\) mediante proposición 3.4.
Solución ejercicio 3.21 Los exponentes son
\[a_A=2, \qquad a_B=1, \qquad a_D=-3.\]
Por proposición 3.4,
\[u_r^2(Q) \approx 2^2u_r^2(A) + 1^2u_r^2(B) + (-3)^2u_r^2(D).\]
En forma decimal,
\[u_r^2(Q) \approx 4(0.010)^2 + (0.020)^2 + 9(0.005)^2.\]
Por tanto,
\[u_r^2(Q) \approx 0.0004+0.0004+0.000225 = 0.001025.\]
Luego
\[u_r(Q) \approx \sqrt{0.001025} \approx 0.0320.\]
Es decir,
\[\boxed{ u_r(Q)\approx3.2\%. }\]
Obsérvese que el signo negativo del exponente de \(D\) desaparece al elevarlo al cuadrado en el caso no correlacionado. Eso no significa que el signo carezca siempre de importancia: en presencia de covarianzas, los productos \(a_i a_j\) de los términos cruzados sí conservan información de signo.
Cierre conceptual
En esta sección hemos pasado de una escala absoluta a una escala normalizada: \(u(x) \longrightarrow u_r(x)=\frac{u(x)}{|x|}.\) La normalización permite comparar resultados de tamaños distintos y revela la estructura especialmente simple de los modelos multiplicativos.
Pero también introduce una nueva condición de uso: \(x\neq0.\) Por eso no debemos convertir automáticamente toda incertidumbre en un porcentaje. La forma relativa es una herramienta de modelización y comparación, no un sustituto universal de la incertidumbre absoluta.
Con esta distinción cerramos el bloque dedicado a la medición y su incertidumbre. A partir de §10 cambiaremos de problema: ya no preguntaremos sólo cómo evaluar un resultado medido, sino cómo construir una estimación física razonada cuando los datos son incompletos y el objetivo es identificar la escala correcta del fenómeno.
10. Estimación física y órdenes de magnitud
Intuir: estimar no es adivinar
Consideremos la pregunta:
¿Qué masa de agua contiene aproximadamente una piscina rectangular?
Una respuesta como
«unas cien toneladas»
puede acertar por casualidad y, sin embargo, no constituir todavía una estimación física. Para estimar necesitamos mostrar cómo llegamos al número. Supongamos una piscina de dimensiones aproximadas
\[25\,\mathrm m\times10\,\mathrm m\times2\,\mathrm m.\]
Su volumen es del orden de
\[V\sim25\times10\times2\,\mathrm{m^3}=5\times10^2\,\mathrm{m^3}.\]
Si adoptamos para el agua la escala
\[\rho\sim10^3\,\mathrm{kg/m^3},\]
entonces
\[m\sim\rho V\sim(10^3)(5\times10^2)\,\mathrm{kg}=5\times10^5\,\mathrm{kg}.\]
El valor es aproximado, pero su procedencia es auditable. Podemos discutir las dimensiones elegidas, la profundidad representativa, la densidad utilizada y la precisión pretendida. Ésta es la diferencia fundamental entre adivinar y estimar.
Definir: estimación física
Definición operativa 3.17 — Estimación física Una estimación física es una inferencia cuantitativa aproximada obtenida a partir de un modelo simplificado, escalas representativas, datos aproximados o cotas plausibles, de modo que las hipótesis empleadas y la precisión pretendida permanezcan explícitas.
Una estimación no exige conocer todos los detalles del sistema. Exige, en cambio, distinguir entre lo que sabemos, lo que suponemos y lo que estamos despreciando. Podemos resumir el proceso por
\[\boxed{\text{pregunta}\longrightarrow\text{modelo simplificado}\longrightarrow\text{escalas}\longrightarrow\text{cálculo}\longrightarrow\text{control}.}\]
Principio 3.9 — Una estimación debe exponer su modelo Un número aproximado sólo se convierte en una estimación física controlable cuando deja visibles las cantidades intermedias, las escalas adoptadas y las simplificaciones que conducen al resultado.
Qué problema resuelve una estimación
La medición y la estimación responden a problemas distintos. En una medición disponemos de un procedimiento experimental y queremos caracterizar un resultado junto con su incertidumbre. En una estimación, en cambio, puede faltar una medición directa o puede ser innecesaria para la pregunta planteada. Queremos saber, por ejemplo, si una energía está más cerca de \(10^3\) que de \(10^{12}\,\mathrm J\), si un tiempo característico es de segundos, horas o años, o si el resultado detallado de un cálculo numérico es físicamente plausible.
La estimación es entonces una herramienta de orientación cuantitativa. No sustituye una medición cuando se necesita medir ni un cálculo detallado cuando el problema exige precisión fina.
El modelo simplificado es la parte principal
Supongamos que queremos estimar el número de granos contenidos en un recipiente. Una estrategia posible es escribir
\[N\sim\frac{V_{\mathrm{recipiente}}}{V_{\mathrm{grano}}}.\]
Esta expresión no es todavía un cálculo. Es una decisión de modelización. Estamos suponiendo implícitamente, entre otras cosas, que existe un volumen representativo para cada grano y que los huecos entre granos pueden incorporarse como un factor de orden uno o ignorarse si sólo buscamos una escala gruesa.
El número final dependerá de las cifras introducidas, pero la calidad de la estimación depende primero de si esta descomposición representa adecuadamente el fenómeno para el propósito buscado.
Escalas representativas
En una estimación rara vez necesitamos comenzar con muchos dígitos. Podemos escribir
\[L\sim3\,\mathrm m,\]
\[t\sim10^2\,\mathrm s,\]
o
\[v\sim20\,\mathrm{m/s}\]
cuando ésas son las escalas que el problema justifica. La notación
\[Q\sim\widetilde Q\]
se utilizará aquí informalmente para expresar que \(\widetilde Q\) representa una escala o valor aproximado razonable para \(Q\). No debe confundirse con una igualdad exacta ni con una relación asintótica formal.
Estimación de valor y orden de magnitud
Una estimación puede conservar más información que su orden de magnitud. Por ejemplo, \(Q\sim8\times10^6\)
es una estimación de valor.
Decir únicamente que \(Q\) es del orden de
\[10^7\]
es una afirmación más gruesa. Perdemos deliberadamente el factor \(8\) y conservamos sólo la escala decimal dominante. Por tanto,
\[\boxed{\text{valor estimado}\neq\text{orden de magnitud}.}\]
Definir: orden de magnitud
La expresión «orden de magnitud» se utiliza con más de una convención en la literatura. Para evitar ambigüedad, este tratado adoptará una convención explícita.
Definición operativa 3.18 — Orden de magnitud decimal Sea \(q>0\) el valor numérico de una cantidad expresada en una unidad previamente fijada. Definimos su orden de magnitud decimal como la potencia de diez más cercana en escala logarítmica:
\[\operatorname{OM}(q)=10^n,\]
donde
\[n=\left\lfloor\log_{10}q+\frac12\right\rfloor\]
Si \(q=10^{n+1/2}\), el empate se resuelve a favor de la potencia superior, coherentemente con la función piso indicada. Equivalentemente, \(\operatorname{OM}(q)=10^n\)
cuando
\[10^{n-\frac12}\le q<10^{n+\frac12}.\]
Por ejemplo, \(\operatorname{OM}(8\times10^6)=10^7,\)
mientras
\[\operatorname{OM}(2\times10^6)=10^6.\]
Convención editorial Algunos textos utilizan «orden de magnitud» para referirse simplemente a la potencia \(10^n\) que fija la década \(10^n\le q<10^{n+1}\). Aquí no adoptaremos esa convención. Cuando necesitemos hablar de la década decimal lo diremos explícitamente.
Una sutileza: las cantidades dimensionales necesitan una unidad declarada
Consideremos una longitud
\[L=3\times10^{-3}\,\mathrm m.\]
La misma longitud puede escribirse
\[L=3\,\mathrm{mm}.\]
El valor numérico ha cambiado. Por tanto, no tiene sentido asignar un orden de magnitud al número desnudo asociado a una cantidad dimensional sin indicar la unidad utilizada. Debemos decir, por ejemplo,
el valor numérico de \(L\) expresado en metros es del orden de \(10^{-3}\),
o trabajar con una cantidad adimensional.
Así,
\[\boxed{\text{el orden de magnitud de una cantidad dimensional requiere una convención de unidad}.}\]
Control dimensional de una estimación
Una estimación debe respetar las dimensiones físicas.
Supongamos que intentamos estimar una energía mediante \(E\sim mv.\)
Entonces \([mv]=MLT^{-1},\)
que no tiene dimensión de energía. La estimación falla antes de introducir números. En cambio, \(E\sim mv^2\)
posee dimensión
\[ML^2T^{-2}.\]
Esto no demuestra que la ley física exacta sea \(E=mv^2\). Sólo demuestra que la expresión ha superado un filtro necesario.
Control rápido Antes de evaluar numéricamente una estimación, comprueba que la combinación propuesta tiene las dimensiones de la magnitud buscada.
Falsa precisión en una estimación
Supongamos una tasa aproximada
\[r\sim17\,\mathrm{min^{-1}}\]
y un tiempo exacto de conversión
\[T=365\times24\times60\,\mathrm{min}.\]
La calculadora puede producir
\[rT=8\,935\,200.\]
Pero si \(17\,\mathrm{min^{-1}}\) era sólo una tasa representativa, el resultado no contiene siete cifras de información física. Una presentación coherente puede ser
\[N\sim9\times10^6,\]
o, si sólo interesa la escala, \(\operatorname{OM}(N)=10^7.\) La calculadora multiplica dígitos. No multiplica conocimiento.
Estimar antes de calcular con detalle
Una estimación preliminar cumple una función diagnóstica.
Supongamos que un cálculo detallado produce \(Q=4.7\times10^{11}\,\mathrm J,\)
mientras un razonamiento elemental había situado la escala esperada alrededor de
\[10^5\,\mathrm J.\]
La discrepancia de seis órdenes de magnitud no demuestra automáticamente que el cálculo detallado sea erróneo. Pero obliga a revisar unidades, potencias de diez, conversiones, modelo, parámetros introducidos e hipótesis de la estimación preliminar. Una buena estimación actúa como control de plausibilidad.
Qué precisión debe pretender una estimación
La precisión buscada depende de la pregunta. Si queremos decidir entre
\[10^{-3}\]
y
\[10^6,\]
un factor dos es irrelevante. Si queremos distinguir entre \(1.1\) y \(1.2\), una estimación de orden de magnitud es insuficiente.
Por tanto, antes de estimar conviene preguntar:
¿qué decisión debe permitirnos el resultado?
La precisión útil no se determina por el número de operaciones disponibles, sino por la escala de la pregunta.
Ejercicio 3.22 — Del modelo al orden de magnitud. Función pedagógica: Construcción → Control dimensional → Orden de magnitud
Una piscina rectangular tiene aproximadamente
\[25\,\mathrm m\times10\,\mathrm m\times2\,\mathrm m.\]
Usa
\[\rho_{\mathrm{agua}}\sim10^3\,\mathrm{kg/m^3}.\]
Estima el volumen.
Estima la masa de agua.
Determina el orden de magnitud decimal de la masa usando definición 3.18.
Explica por qué escribir muchos decimales no mejoraría la estimación.
Solución
\[V\sim25\times10\times2=500\,\mathrm{m^3}=5\times10^2\,\mathrm{m^3}.\]
Entonces \(m\sim\rho V\sim(10^3)(5\times10^2)=5\times10^5\,\mathrm{kg}.\)
Como \(5\times10^5>10^{5.5},\)
la potencia de diez más cercana es
\[\boxed{\operatorname{OM}(m)=10^6\,\mathrm{kg}}\]
cuando el valor numérico se expresa en kilogramos.
Los datos han sido introducidos como escalas aproximadas. Añadir decimales al resultado final no añadiría información sobre esas aproximaciones.
Ejercicio 3.23 — El orden de magnitud y la unidad. Función pedagógica: Diagnóstico → No-ejemplo → Autoexplicación
Una longitud se escribe como \(L=3\times10^{-3}\,\mathrm m.\) La misma longitud puede escribirse como \(L=3\,\mathrm{mm}.\) Un estudiante afirma: «La longitud cambió de orden de magnitud al cambiar de metros a milímetros». Analiza la afirmación.
Solución
La cantidad física no ha cambiado. Lo que ha cambiado es su valor numérico respecto de la unidad elegida. En metros, \(\frac{L}{1\,\mathrm m}=3\times10^{-3},\)
mientras en milímetros, \(\frac{L}{1\,\mathrm{mm}}=3.\) Por eso una afirmación sobre orden de magnitud de una cantidad dimensional debe especificar la unidad o normalización utilizada. Una formulación correcta sería: «el valor numérico de \(L\) expresado en metros está en la escala de \(10^{-3}\)».
Cierre: estimar es construir una explicación cuantitativa
Una estimación física bien construida contiene más que un número. Contiene
\[\boxed{\text{modelo}+\text{escalas}+\text{cálculo}+\text{control}.}\]
En esta sección hemos fijado la base.
En §11 estudiaremos una estrategia particularmente poderosa para problemas donde la cantidad buscada debe reconstruirse a partir de varios factores accesibles:
\[\boxed{\text{estimaciones tipo Fermi}.}\]
Después, en §12, analizaremos cómo someter esas estimaciones a pruebas de robustez, cotas y caminos independientes.
11. Estimaciones tipo Fermi
Intuir: una cantidad difícil puede descomponerse
Hay preguntas cuantitativas para las que no disponemos de un dato directo:
¿Cuántas respiraciones realiza aproximadamente una persona en un año?
Podríamos intentar recordar una cifra publicada. Pero también podemos reconstruir la respuesta a partir de cantidades más accesibles. Tomemos una frecuencia respiratoria representativa
\[f\sim15\,\mathrm{min^{-1}}.\]
Un año contiene aproximadamente
\[T \sim 365\times24\times60\,\mathrm{min} \approx 5.3\times10^5\,\mathrm{min}.\]
Entonces
\[N \sim fT \sim (15)(5.3\times10^5) \sim 8\times10^6.\]
Con la convención definición 3.18, \(\operatorname{OM}(N)=10^7.\) La idea esencial no es la cifra final. Es la descomposición
\[\boxed{ \text{respiraciones} = \frac{\text{respiraciones}}{\text{minuto}} \times \frac{\text{minutos}}{\text{año}}. }\]
La cantidad difícil ha sido sustituida por factores más accesibles.
Definir: estimación tipo Fermi
Definición operativa 3.19 — Estimación tipo Fermi Una estimación tipo Fermi es una estimación física en la que una cantidad difícil de conocer directamente se reconstruye mediante una descomposición en factores, cocientes o escalas más accesibles, cada uno evaluado con la precisión necesaria para la pregunta planteada.
En forma esquemática, \(Q = q_1q_2\cdots q_r\)
puede estimarse mediante
\[Q \sim \widetilde q_1 \widetilde q_2 \cdots \widetilde q_r.\]
La estructura puede incluir también cocientes:
\[Q \sim \frac{\widetilde q_1\widetilde q_2} {\widetilde q_3}.\]
Lo decisivo es que el modelo permanezca visible. Una estimación tipo Fermi no es una licencia para elegir números arbitrarios. Es una estrategia para reemplazar una incógnita global por varias incógnitas locales más manejables.
Del problema al árbol de factores
Antes de introducir números conviene construir un árbol conceptual.
Supongamos que queremos estimar el número de vasos de agua consumidos por una población en un día. Una posible descomposición es
\[N_{\mathrm{vasos}} \sim N_{\mathrm{personas}} \times \frac{\mathrm{L}}{\text{persona\,día}} \times \frac{\mathrm{vasos}}{\mathrm L}.\]
Cada factor responde una pregunta distinta:
¿cuántas personas intervienen?;
¿qué consumo diario por persona adoptamos?;
¿cuántos vasos corresponden aproximadamente a un litro?
La estimación completa es una red de decisiones pequeñas.
Pausa de modelización Antes de calcular, escribe la descomposición simbólica y comprueba que cada factor tenga una interpretación física propia y aporte información no duplicada.
El control dimensional funciona también como control semántico
En una estimación de Fermi, las unidades pueden detectar una descomposición mal construida. En el ejemplo anterior,
\[\left[ N_{\mathrm{personas}} \times \frac{\mathrm L}{\text{persona\,día}} \times \frac{\mathrm{vasos}}{\mathrm L} \right] = \frac{\mathrm{vasos}}{\text{día}}.\]
Las unidades intermedias
\[\mathrm{persona}\]
y
\[\mathrm L\]
se cancelan.
Esto no demuestra que los valores representativos sean correctos, pero confirma que el producto responde a la pregunta dimensional formulada.
Una cadena con unidades que no se cancelan como esperamos suele señalar:
un factor ausente;
un factor invertido;
una doble contabilización;
una pregunta mal formulada.
Potencias de diez: la aritmética de escalas
Supongamos que
\[q_i \sim a_i10^{n_i},\]
con
\[1\le a_i<10.\]
Entonces \(Q = \prod_{i=1}^r q_i\)
se estima como
\[Q \sim \left( \prod_{i=1}^r a_i \right) 10^{\sum_{i=1}^r n_i}.\]
La parte exponencial se controla mediante una suma:
\[\boxed{ 10^{n_1} 10^{n_2} \cdots 10^{n_r} = 10^{n_1+n_2+\cdots+n_r}. }\]
En forma logarítmica, si \(Q\) y \(q_i\) representan sus valores numéricos positivos expresados en unidades coherentes previamente fijadas, \(\log_{10}|Q| = \sum_{i=1}^r \log_{10}|q_i|.\) Por eso una estimación multiplicativa puede pensarse como una contabilidad aditiva de exponentes. No tomamos el logaritmo de una cantidad dimensional: los logaritmos de esta igualdad actúan sobre valores numéricos con sus unidades ya declaradas (definición 3.18).
Esta observación es especialmente útil para hacer cálculos mentales de escala.
Los coeficientes de orden uno todavía importan
No debemos confundir «trabajar con potencias de diez» con «borrar todos los coeficientes».
Supongamos \(Q \sim (5\times10^2) (4\times10^3).\) Si conservamos los coeficientes, \(Q \sim 20\times10^5 = 2\times10^6.\) Con la convención definición 3.18, \(\operatorname{OM}(Q)=10^6.\) Si reemplazáramos prematuramente ambos factores por \(10^3\)
y
\[10^4,\]
obtendríamos
\[10^7,\]
una escala diferente. Por tanto, una buena estimación de orden de magnitud no consiste en redondear cada factor brutalmente antes de multiplicar. Conviene conservar suficientes coeficientes de orden uno hasta el final y determinar entonces la potencia de diez más cercana.
Ejemplo desarrollado: cuánta lluvia cae sobre una manzana urbana
Queremos estimar el volumen de agua que cae sobre una manzana de aproximadamente
\[100\,\mathrm m \times 100\,\mathrm m\]
durante una lluvia acumulada de
\[20\,\mathrm{mm}.\]
Primero convertimos
\[20\,\mathrm{mm} = 2\times10^{-2}\,\mathrm m.\]
El área es
\[A \sim 10^2\,\mathrm m \times 10^2\,\mathrm m = 10^4\,\mathrm{m^2}.\]
El volumen de precipitación es
\[V \sim Ah \sim (10^4)(2\times10^{-2})\,\mathrm{m^3} = 2\times10^2\,\mathrm{m^3}.\]
Como \(1\,\mathrm{m^3} = 10^3\,\mathrm L,\)
obtenemos \(V \sim 2\times10^5\,\mathrm L.\) La estimación nos sitúa en la escala de cientos de miles de litros. No hemos modelado desagües, evaporación, superficies permeables ni geometría real de la manzana. Eso no invalida el cálculo.
Define el alcance de la pregunta que realmente hemos contestado:
volumen total de precipitación equivalente sobre una superficie horizontal de esa escala.
Un factor debe representar una sola idea
Un error frecuente consiste en introducir dos factores que contienen la misma información.
Supongamos que estimamos el consumo diario de agua de un edificio mediante
\[N_{\mathrm{personas}} \times \frac{\mathrm L}{\text{persona\,día}}.\]
Si el valor de
\[\frac{\mathrm L}{\text{persona\,día}}\]
ya incluye duchas, cocina y limpieza, no debemos multiplicar después por un nuevo «factor de duchas» como si aportara información adicional no contenida ya en el consumo agregado. Eso produciría una doble contabilización.
Prueba de estrés — ¿Este factor añade información nueva? Antes de incorporar un factor a una estimación, pregunta si representa una dependencia nueva o si ya está contenida en otro valor agregado.
Descomponer hasta que los factores sean estimables
Una descomposición es útil si transforma una pregunta difícil en preguntas que podemos contestar razonablemente. Si escribimos
\[Q \sim A B,\]
pero tanto
\[A\]
como
\[B\]
son tan desconocidos como
\[Q,\]
no hemos ganado mucho.
La descomposición debe continuar hasta llegar a cantidades para las que podamos:
recordar una escala razonable;
inferir una escala geométricamente;
obtener una cota sencilla;
utilizar una constante física conocida;
formular un valor representativo defendible.
El objetivo no es maximizar el número de factores. Es maximizar la auditabilidad del razonamiento.
Demasiados factores pueden ocultar el problema
Una cadena larga parece sofisticada: \(Q \sim q_1q_2q_3\cdots q_{12}.\) Pero cada factor introduce una nueva decisión. Si muchos de ellos son débilmente conocidos, la aparente precisión del producto puede ser ilusoria.
Por eso una estimación Fermi debe buscar un equilibrio:
La cuestión de cuánto pueden acumularse los factores inciertos será tratada sistemáticamente en §12.
Fermi no significa necesariamente “producto”
La estructura multiplicativa es frecuente, pero no obligatoria.
Podemos encontrar modelos como
\[Q \sim \frac{A}{B},\]
\[Q \sim A+B,\]
o
\[Q \sim A(B-C).\]
Lo importante es construir una relación que conecte la cantidad buscada con cantidades más accesibles. Por ejemplo, para estimar un tiempo de llenado, \(t \sim \frac{V}{\dot V},\)
donde
\[V\]
es un volumen y
\[\dot V\]
un caudal.
Las unidades verifican:
\[\frac{\mathrm{m^3}} {\mathrm{m^3/s}} = \mathrm s.\]
Una estimación Fermi no es una evaluación GUM de incertidumbre
En §§5–9 trabajamos con incertidumbres estándar, covarianzas, propagación y reporte metrológico.
Aquí hacemos otra cosa. Cuando decimos que un factor es «aproximadamente»
\[2\]
o que podría variar «por un factor del orden de dos», no estamos declarando automáticamente:
una desviación estándar;
una distribución de probabilidad;
una probabilidad de cobertura;
una incertidumbre expandida.
Por tanto,
\[\boxed{ \text{factor de plausibilidad en una estimación Fermi} \neq \text{incertidumbre estándar}. }\]
Podemos conectar ambos lenguajes sólo si construimos explícitamente un modelo probabilístico o metrológico adicional. Esta separación evita importar de manera ilegítima la semántica de §5–§9 a un problema de estimación gruesa.
Ejercicio 3.24 — Respiraciones en un año. Función pedagógica: Descomposición → Escalas → Orden de magnitud
Estima el número de respiraciones de una persona en un año usando: \(f\sim15\,\mathrm{min^{-1}}.\)
Construye primero la descomposición simbólica.
Calcula una estimación de valor.
Determina su orden de magnitud decimal según la definición 3.18.
Explica qué información adicional necesitarías para convertir este ejercicio en un problema metrológico de incertidumbre.
Solución
La descomposición es \(N \sim fT.\) Un año contiene aproximadamente
\[T = 365\times24\times60\,\mathrm{min} \approx 5.26\times10^5\,\mathrm{min}.\]
Entonces
\[N \sim (15)(5.26\times10^5) \approx 7.9\times10^6.\]
Por definición 3.18,
\[\boxed{ \operatorname{OM}(N)=10^7. }\]
Para una evaluación metrológica necesitaríamos especificar qué población o persona se estudia, cómo se mide la frecuencia respiratoria, su variabilidad, el modelo temporal, las fuentes de incertidumbre y la interpretación probabilística correspondiente. El valor representativo \(15\,\mathrm{min^{-1}}\) no contiene por sí solo esa información.
Ejercicio 3.25 — Agua caída sobre un campo. Función pedagógica: Modelo geométrico → Conversión → Control dimensional
Un campo rectangular mide aproximadamente
\[100\,\mathrm m \times 50\,\mathrm m.\]
Durante una tormenta caen
\[30\,\mathrm{mm}\]
de precipitación acumulada.
Estima el volumen total de agua que corresponde a esa precipitación.
Exprésalo en metros cúbicos y litros.
Determina el orden de magnitud del número de litros.
Identifica dos procesos físicos que este modelo no intenta describir.
Solución
El área es
\[A \sim (100)(50)\,\mathrm{m^2} = 5\times10^3\,\mathrm{m^2}.\]
La altura de precipitación es \(h = 30\,\mathrm{mm} = 3\times10^{-2}\,\mathrm m.\) Por tanto,
\[V \sim Ah = (5\times10^3)(3\times10^{-2}) \,\mathrm{m^3} = 1.5\times10^2\,\mathrm{m^3}.\]
Como \(1\,\mathrm{m^3}=10^3\,\mathrm L,\)
resulta \(V \sim 1.5\times10^5\,\mathrm L.\)
Según definición 3.18,
\[\boxed{ \operatorname{OM}(V)=10^5\,\mathrm L. }\]
El modelo no intenta describir, por ejemplo, infiltración, escorrentía, evaporación, almacenamiento superficial ni variaciones espaciales de la lluvia. Calcula el volumen de precipitación equivalente sobre el área geométrica indicada.
Cierre: descomponer para poder pensar
Una estimación tipo Fermi transforma
\[\text{una pregunta global difícil}\]
en
\[\text{varias preguntas locales manejables}.\]
Su arquitectura mínima es
\[\boxed{\begin{gathered} \text{cantidad buscada} \to \text{descomposición}\\[2pt]\Downarrow\\[2pt]\text{factores estimables} \to \text{cálculo de escala}\\[2pt]\Downarrow\\[2pt]\text{control dimensional y conceptual}. \end{gathered}}\]
Hemos aprendido a construir la estimación.
Todavía falta una pregunta decisiva:
¿cuánto cambia la conclusión si nuestras escalas cambian?
Ése será el problema de §12:
\[\boxed{ \text{robustez, cotas y estimación por caminos independientes}. }\]
12. Robustez, cotas y estimación por caminos independientes
Intuir: una estimación no termina en el número central
Supongamos que una estimación tipo Fermi produce \(Q\sim 8\times10^5.\)
Podemos calcular su orden de magnitud y obtener
\[\operatorname{OM}(Q)=10^6.\]
Pero todavía falta una pregunta esencial:
¿seguiríamos llegando a la misma conclusión si cambiáramos razonablemente las hipótesis?
Una estimación física no sólo debe producir una escala.
Debe permitirnos estudiar cuánto depende esa escala de las elecciones introducidas.
Éste es el problema de la robustez. La pregunta deja de ser simplemente
\[\text{¿cuánto vale aproximadamente }Q?\]
y pasa a ser
\[\boxed{ \text{¿qué parte de la conclusión sobrevive cuando variamos las premisas?} }\]
Factores de variación
Sea una cantidad positiva estimada mediante
\[\widetilde Q = C\prod_{i=1}^{N}\widetilde q_i^{a_i},\]
donde
\[C>0\]
es exacta para el modelo y
\[\widetilde q_i>0.\]
Supongamos ahora que el valor real de cada factor relevante no se conoce exactamente, pero podemos defender una cota multiplicativa
\[\frac{\widetilde q_i}{f_i} \le q_i \le f_i\widetilde q_i,\]
con
\[f_i\ge1.\]
Decir, por ejemplo, que
\[f_i=2\]
significa:
para el propósito de esta estimación, considero plausible que el factor esté entre la mitad y el doble del valor representativo.
Esta afirmación es una cota multiplicativa de plausibilidad.
No es, por sí sola, una desviación estándar ni una probabilidad de cobertura.
Resultado formal: acumulación de factores multiplicativos
Proposición 3.5 — Cota multiplicativa acumulada para un modelo monomial Sea
\[Q = C\prod_{i=1}^{N}q_i^{a_i},\]
con
\[C>0, \qquad q_i>0,\]
y sea
\[\widetilde Q = C\prod_{i=1}^{N}\widetilde q_i^{a_i}.\]
Si para cada entrada existe
\[f_i\ge1\]
tal que
\[\frac1{f_i} \le \frac{q_i}{\widetilde q_i} \le f_i,\]
entonces
\[\boxed{ \frac1F \le \frac{Q}{\widetilde Q} \le F, }\]
donde
\[\boxed{ F = \prod_{i=1}^{N}f_i^{|a_i|}. }\]
Demostración
Definamos
\[r_i = \frac{q_i}{\widetilde q_i}.\]
Por hipótesis, \(\frac1{f_i} \le r_i \le f_i.\)
Además,
\[\frac{Q}{\widetilde Q} = \prod_{i=1}^{N}r_i^{a_i}.\]
Si
\[a_i\ge0,\]
entonces \(f_i^{-|a_i|} \le r_i^{a_i} \le f_i^{|a_i|}.\)
Si
\[a_i<0,\]
la inversión intercambia los extremos, pero vuelve a obtenerse
\[f_i^{-|a_i|} \le r_i^{a_i} \le f_i^{|a_i|}.\]
Multiplicando todas las desigualdades positivas,
\[\prod_i f_i^{-|a_i|} \le \prod_i r_i^{a_i} \le \prod_i f_i^{|a_i|}.\]
Como \(\prod_i r_i^{a_i} = \frac{Q}{\widetilde Q},\)
y
\[F = \prod_i f_i^{|a_i|},\]
resulta
\[\frac1F \le \frac{Q}{\widetilde Q} \le F. \qquad\square\]
Proposición 3.5 no es una ley probabilística. Es una afirmación determinista sobre cotas multiplicativas declaradas.
El ejemplo \(2^5=32\)
Supongamos un producto de cinco factores: \(Q=q_1q_2q_3q_4q_5.\) Si cada uno se conoce sólo dentro de un factor
\[2,\]
entonces proposición 3.5 da \(F = 2^5 = 32.\) Por tanto,
\[\frac{\widetilde Q}{32} \le Q \le 32\widetilde Q.\]
Un factor individual de dos puede parecer pequeño.
Cinco factores de dos no lo son.
Como \(32>10,\)
la acumulación ya permite un desplazamiento superior a una década decimal completa.
Ésta es una razón para preferir descomposiciones con pocos factores relevantes y para no introducir factores débilmente conocidos sin necesidad.
La visión logarítmica
Tomando logaritmos en la proposición 3.5,
\[\left| \log_{10}\!\left(\frac{Q}{\widetilde Q}\right) \right| \le \log_{10}F.\]
Como \(F = \prod_i f_i^{|a_i|},\)
tenemos
\[\boxed{ \log_{10}F = \sum_i |a_i|\log_{10}f_i. }\]
Así, las incertidumbres multiplicativas de escala se vuelven aditivas en el espacio logarítmico.
Esta fórmula muestra qué factores dominan la fragilidad de una estimación:
factores con gran \[f_i;\]
factores elevados a exponentes de gran módulo \[|a_i|.\]
La estructura recuerda la propagación relativa de §9, pero no debe confundirse con ella: aquí trabajamos con cotas multiplicativas, no con varianzas.
¿Cuándo es robusto el orden de magnitud?
Recordemos definición 3.18. Fijada una unidad \(Q_0\) de la misma dimensión que \(Q\), el orden de magnitud decimal del valor numérico \(Q/Q_0\) cambia cuando su logaritmo cruza una frontera de la forma \(n+\frac12.\) Supongamos que nuestra estimación central es \(\widetilde Q>0\)
y que proposición 3.5 garantiza
\[\frac{\widetilde Q}{F} \le Q \le F\widetilde Q.\]
En escala logarítmica, el valor verdadero debe encontrarse dentro de
\[\log_{10}\!\left(\frac{\widetilde Q}{Q_0}\right) \pm \log_{10}F.\]
Por tanto, el orden de magnitud queda garantizado si todo ese intervalo permanece dentro de una misma celda
\[\left[ n-\frac12, n+\frac12 \right).\]
Éste es un criterio más preciso que decir simplemente:
«los factores parecen pequeños».
Prueba de robustez del orden de magnitud 1. Calcula el orden central según la definición 3.18. 2. Construye una cota multiplicativa total \(F\). 3. Comprueba si el intervalo \[[\widetilde Q/F,\;F\widetilde Q]\] cruza alguna frontera entre órdenes de magnitud. 4. Si no la cruza, la conclusión de orden de magnitud es robusta respecto de esas cotas.
Ejemplo: una escala robusta pese a una cota amplia
Consideremos una ciudad con
\[N \sim 5\times10^5\]
habitantes.
Supongamos que el consumo diario por persona está entre
\[100\]
y
\[400\,\text{L/persona/día}.\]
Entonces
\[V_{\min} = (5\times10^5)(10^2) = 5\times10^7\,\text{L/día},\]
mientras
\[V_{\max} = (5\times10^5)(4\times10^2) = 2\times10^8\,\text{L/día}.\]
Tenemos \(5\times10^7 \le V \le 2\times10^8.\) Con definición 3.18, \(\operatorname{OM}(5\times10^7)=10^8\)
y
\[\operatorname{OM}(2\times10^8)=10^8.\]
Por tanto,
\[\boxed{ \operatorname{OM}(V)=10^8\,\text{L/día} }\]
es robusto frente a toda la variación declarada. La cifra central puede cambiar mucho. La conclusión de escala no.
Cuando la cota cruza una frontera
Supongamos, en cambio, \(3\times10^6 \le Q \le 8\times10^7.\) El extremo inferior está cerca de la frontera entre los órdenes
\[10^6\]
y
\[10^7,\]
mientras el superior pertenece claramente a la escala de
\[10^8\]
según la definición 3.18. En ese caso no debemos fingir un único orden de magnitud robusto.
Una comunicación más fiel es conservar la cota:
\[\boxed{ 3\times10^6 \lesssim Q \lesssim 8\times10^7. }\]
Cotar puede transmitir más información que forzar una única potencia de diez.
Cotas asimétricas
No toda incertidumbre de escala tiene que ser simétrica alrededor de un valor representativo.
Podemos saber, por ejemplo, que
\[q_{\min} \le q \le q_{\max},\]
sin que exista un único factor
\[f\]
razonable que describa ambas direcciones. En ese caso debemos propagar directamente los extremos si el modelo es monótono en las variables pertinentes. Para
\[Q=AB,\]
con
\[A_{\min}\le A\le A_{\max},\]
y
\[B_{\min}\le B\le B_{\max},\]
si todas las cantidades son positivas, \(A_{\min}B_{\min} \le Q \le A_{\max}B_{\max}.\)
Las cotas deben seguir la estructura real del modelo.
No es obligatorio convertir todo problema en un porcentaje simétrico.
Dos caminos hacia la misma cantidad
Una estimación puede ser internamente consistente y, sin embargo, apoyarse en una hipótesis equivocada. Una forma poderosa de control consiste en construir la misma cantidad mediante otro modelo. Por ejemplo, estimemos el volumen corporal de una persona adulta.
Camino A — masa y densidad
Tomemos
\[m\sim70\,\mathrm{kg}\]
y una densidad corporal media de escala comparable a la del agua: \(\rho\sim10^3\,\mathrm{kg/m^3}.\) Entonces
\[V_A \sim \frac{m}{\rho} \sim \frac{70}{10^3}\,\mathrm{m^3} = 7\times10^{-2}\,\mathrm{m^3}.\]
Camino B — geometría gruesa
Tomemos una altura
\[h\sim1.7\,\mathrm m\]
y un área transversal representativa
\[A\sim4\times10^{-2}\,\mathrm{m^2}.\]
Entonces
\[V_B \sim Ah \sim (4\times10^{-2})(1.7)\,\mathrm{m^3} \sim 7\times10^{-2}\,\mathrm{m^3}.\]
Dos modelos muy distintos conducen a la misma escala.
Eso aumenta la credibilidad de la conclusión.
Principio 3.10 — Dos rutas independientes son una herramienta diagnóstica Cuando una cantidad puede estimarse mediante dos descomposiciones conceptualmente distintas, la concordancia de escalas refuerza la plausibilidad del resultado; una discrepancia grande señala que al menos una ruta, un dato o una hipótesis debe ser revisado.
“Independientes” no significa independencia estadística
La palabra independientes en el principio 3.10 no tiene aquí el significado probabilístico utilizado al hablar de variables aleatorias. Queremos rutas que compartan la menor cantidad posible de supuestos estructurales. Por ejemplo, \(V \sim \frac{m}{\rho}\)
y
\[V \sim Ah\]
usan ideas diferentes. En cambio, dos cálculos que reutilizan el mismo consumo por persona expresado en unidades distintas no constituyen dos caminos conceptualmente independientes. Por tanto,
\[\boxed{ \text{independencia de rutas de estimación} \neq \text{independencia estadística}. }\]
La discrepancia es información
Supongamos que dos rutas producen
\[Q_A \sim 3\times10^4\]
y
\[Q_B \sim 5\times10^8.\]
La diferencia de más de cuatro órdenes de magnitud no debe resolverse promediando: \(\frac{Q_A+Q_B}{2}.\) Eso ocultaría el problema.
La discrepancia debe desencadenar una auditoría:
¿las dos rutas calculan realmente la misma magnitud?;
¿hay una conversión de unidades equivocada?;
¿algún factor está invertido?;
¿hay doble contabilización?;
¿una escala representativa es absurda?;
¿algún modelo omite un mecanismo dominante?
Una gran discrepancia no es un fracaso inútil. Es una señal diagnóstica.
Robustez no significa exactitud
Una estimación puede ser muy robusta y seguir siendo gruesa. Si muchas variaciones razonables de las premisas producen siempre
\[Q\sim10^8,\]
podemos tener mucha confianza en la escala.
Eso no implica conocer
\[Q\]
con cuatro cifras significativas. De modo inverso, una estimación central aparentemente precisa puede ser frágil si pequeñas variaciones de las premisas la desplazan por varios órdenes de magnitud.
Por tanto debemos separar:
\[\boxed{ \text{robustez de la conclusión} \neq \text{precisión numérica fina}. }\]
Ejercicio 3.26 — Cotas y dos caminos para un consumo urbano. Función pedagógica: Robustez → Cotas → Diagnóstico por rutas
Una ciudad tiene aproximadamente
\[5\times10^5\]
habitantes.
Camino A
Supón un consumo doméstico representativo entre
\[100\]
y
\[400\,\text{L/persona/día}.\]
Construye una cota inferior y superior para el consumo diario total.
Decide si el orden de magnitud decimal es robusto.
Camino B
Un segundo modelo estima
\[1.5\times10^5\]
hogares y un consumo medio del orden de
\[700\,\text{L/hogar/día}.\]
Obtén la estimación del camino B.
Compara ambas rutas.
Explica por qué la concordancia no convierte ninguna de las dos en una medición ni demuestra que sus errores sean estadísticamente independientes.
Solución
Para el camino A,
\[V_{\min} = (5\times10^5)(10^2) = 5\times10^7\,\text{L/día},\]
y
\[V_{\max} = (5\times10^5)(4\times10^2) = 2\times10^8\,\text{L/día}.\]
Así,
\[\boxed{ 5\times10^7 \le V_A \le 2\times10^8\,\text{L/día}. }\]
Ambos extremos tienen, según la definición 3.18, \(\operatorname{OM}=10^8\,\text{L/día}.\) Por tanto, la conclusión de escala es robusta frente a ese intervalo de consumo por persona. Para el camino B, \(V_B \sim (1.5\times10^5)(700) \,\text{L/día}.\) Como \(700=7\times10^2,\)
resulta
\[V_B \sim 10.5\times10^7 = 1.05\times10^8\,\text{L/día}.\]
Así,
\[\boxed{ V_B\sim10^8\,\text{L/día}. }\]
Los dos caminos coinciden en escala y el valor del camino B cae dentro de las cotas del camino A.
Esta concordancia es una evidencia diagnóstica favorable para el modelo de escala, pero no convierte los números adoptados en mediciones ni asigna una distribución probabilística a sus errores. Además, las dos rutas no son completamente independientes si el consumo por hogar fue obtenido a partir de hábitos individuales semejantes a los que sustentan el consumo por persona; esa dependencia conceptual debe reconocerse.
Cierre del bloque de estimación
Las §§10–12 forman ahora una secuencia completa:
\[\boxed{ \text{estimación} \longrightarrow \text{descomposición Fermi} \longrightarrow \text{robustez y control}. }\]
Hemos distinguido:
valor estimado;
orden de magnitud;
factores de plausibilidad;
cotas;
robustez;
concordancia entre rutas.
Y hemos mantenido separadas estas ideas de la semántica metrológica de incertidumbre desarrollada en §§4–9. El capítulo puede pasar ahora a problemas integradores donde ambas mitades —medición y estimación— trabajen juntas.
Ése será el objetivo de §13:
\[\boxed{ \text{casos integradores de medición y estimación}. }\]
13. Casos integradores de medición y estimación
Integrar: una medición completa es una cadena de decisiones
Hasta ahora hemos estudiado por separado mensurando, indicación, resolución, repetición, incertidumbre, propagación, reporte, estimación y orden de magnitud. En un problema real esas piezas aparecen juntas. El esquema de trabajo que utilizaremos en esta sección es
\[\boxed{\begin{gathered} \text{pregunta física} \to \text{mensurando}\\[2pt]\Downarrow\\[2pt]\text{modelo} \to \text{procedimiento}\\[2pt]\Downarrow\\[2pt]\text{datos} \to \text{incertidumbre}\\[2pt]\Downarrow\\[2pt]\text{propagación} \to \text{reporte}\\[2pt]\Downarrow\\[2pt]\text{control de plausibilidad}. \end{gathered}}\]
La estimación previa aparece antes del cálculo detallado y vuelve al final como control.
No es un adorno externo al procedimiento experimental.
Protocolo integrador En cada caso pregunta explícitamente: 1. ¿qué cantidad se pretende conocer?; 2. ¿qué modelo conecta esa cantidad con las observaciones?; 3. ¿qué componentes de incertidumbre se están incluyendo?; 4. ¿qué hipótesis permiten combinarlas?; 5. ¿cómo debe reportarse el resultado?; 6. ¿es físicamente plausible la escala obtenida?
Caso A — Medir una longitud con un calibre digital
Queremos medir el diámetro de una pieza cilíndrica. El mensurando no es «lo que muestra el calibre», sino el diámetro de la pieza bajo las condiciones y procedimiento especificados.
Supongamos cinco indicaciones, en milímetros:
\[20.14, \quad 20.15, \quad 20.13, \quad 20.14, \quad 20.14.\]
La resolución del instrumento es \(\Delta=0.01\,\mathrm{mm}.\)
Antes de calcular, una inspección de los datos ya sitúa el diámetro alrededor de
\[2\times10^1\,\mathrm{mm}.\]
La escala del resultado está clara antes de cualquier estadística.
Centro, dispersión y componente tipo A
La media es \(\bar d = 20.140\,\mathrm{mm}.\) La desviación estándar muestral de las cinco indicaciones es aproximadamente
\[s \approx 0.0071\,\mathrm{mm}.\]
Por tanto, bajo las hipótesis discutidas en §5, la incertidumbre estándar tipo A de la media es
\[u_A(\bar d) = \frac{s}{\sqrt5} \approx 0.0032\,\mathrm{mm}.\]
La dispersión observada y la incertidumbre de la media son cantidades distintas.
Resolución, combinación y reporte
Si modelamos la cuantización debida a la resolución mediante una distribución rectangular de anchura
\[\Delta=0.01\,\mathrm{mm},\]
la componente estándar asociada es
\[u_{\mathrm{res}} = \frac{\Delta}{\sqrt{12}} \approx 0.0029\,\mathrm{mm}.\]
Si tratamos ambas componentes como no correlacionadas,
\[u_c(d) = \sqrt{ u_A^2+ u_{\mathrm{res}}^2} \approx 0.0043\,\mathrm{mm}.\]
Un reporte coherente es
\[\boxed{ d=20.1400\,\mathrm{mm}, \qquad u_c(d)=0.0043\,\mathrm{mm}. }\]
Este ejemplo reúne varias ideas del capítulo:
una indicación no es todavía un resultado completo;
la repetición aporta información sobre dispersión;
la resolución contribuye al presupuesto de incertidumbre;
la combinación requiere una hipótesis sobre dependencia;
el número final debe reportarse con semántica explícita.
Lo que este cálculo no demuestra No hemos incluido, por ejemplo, error geométrico del calibre, temperatura, fuerza de contacto, falta de circularidad de la pieza ni una posible corrección de calibración. Un presupuesto de incertidumbre es tan completo como el modelo que lo sostiene.
Caso B — Medir un período cronometrando muchas oscilaciones
Queremos determinar el período de una oscilación aproximadamente periódica.
Cronometrar una sola oscilación puede hacer que el tiempo de reacción del operador sea comparable con una fracción importante del período. Una estrategia mejor es medir el tiempo total de
\[N=20\]
oscilaciones y utilizar el modelo
\[\boxed{ T=\frac{t}{N}. }\]
Supongamos cinco tiempos totales, en segundos:
\[31.58, \quad 31.65, \quad 31.61, \quad 31.63, \quad 31.59.\]
La media es \(\bar t =31.612\,\mathrm s.\) Por tanto,
\[T = \frac{31.612}{20}\,\mathrm s = 1.5806\,\mathrm s.\]
Una estimación previa de
\[T\sim1.5\,\mathrm s\]
ya nos habría permitido detectar inmediatamente un error como \(T=15.8\,\mathrm s.\)
Propagación en el caso del período
Para los cinco tiempos anteriores, \(s_t \approx 0.0286\,\mathrm s,\)
y
\[u_A(\bar t) \approx 0.0128\,\mathrm s.\]
Si el cronómetro tiene resolución
\[0.01\,\mathrm s,\]
la componente rectangular asociada es \(u_{\mathrm{res}} \approx 0.0029\,\mathrm s.\)
Supongamos además que el procedimiento asigna al efecto de reacción una semiamplitud aproximada de
\[0.10\,\mathrm s\]
modelada rectangularmente. Entonces
\[u_{\mathrm{reac}} = \frac{0.10}{\sqrt3}\,\mathrm s \approx 0.0577\,\mathrm s.\]
Si tratamos las tres contribuciones como no correlacionadas, \(u_c(t) \approx 0.0592\,\mathrm s.\)
Como \(T=\frac{t}{20},\)
el coeficiente de sensibilidad respecto de \(t\) es \(c_t=\frac1{20}.\) Por proposición 3.3,
\[u_c(T) \approx \frac{0.0592}{20}\,\mathrm s \approx 0.0030\,\mathrm s.\]
Podemos reportar
\[\boxed{ T=1.5806\,\mathrm s, \qquad u_c(T)=0.0030\,\mathrm s. }\]
Qué mejora al medir muchas oscilaciones — y qué no
El modelo
\[T=\frac{t}{N}\]
hace que una componente de incertidumbre asociada al tiempo total se divida por
\[N.\]
Pero no toda fuente de error físico queda automáticamente reducida por el mismo factor. Si el sistema cambia de período durante la medición, si se cuentan mal las oscilaciones o si el criterio para determinar el comienzo y el final introduce un efecto sistemático dependiente del procedimiento, aumentar \(N\) no resuelve por sí solo el problema.
Por tanto,
\[\boxed{ \text{aumentar }N \begin{gathered}\text{mejora ciertas}\\\text{contribuciones del}\\\text{modelo, no todas las}\\\text{posibles fuentes de}\\\text{inexactitud.}\end{gathered} }\]
Ésta es una aplicación directa del principio 3.7:
propagar incertidumbre exige propagar también el modelo.
Caso C — Densidad de un bloque a partir de masa y dimensiones
Consideremos un bloque rectangular con
\[m=78.42\,\mathrm g, \qquad u(m)=0.03\,\mathrm g,\]
\[L=4.000\,\mathrm{cm}, \qquad u(L)=0.005\,\mathrm{cm},\]
\[W=2.000\,\mathrm{cm}, \qquad u(W)=0.005\,\mathrm{cm},\]
\[H=1.000\,\mathrm{cm}, \qquad u(H)=0.005\,\mathrm{cm}.\]
El modelo es \(\rho = \frac{m}{LWH}.\)
Antes de calcular con detalle podemos estimar
\[m\sim8\times10^1\,\mathrm g\]
y
\[V\sim8\,\mathrm{cm^3},\]
de modo que
\[\rho\sim10\,\mathrm{g/cm^3}.\]
La estimación previa sitúa inmediatamente la escala esperada.
Propagación relativa y contribución dominante
El volumen nominal es
\[V = (4.000)(2.000)(1.000) \,\mathrm{cm^3} = 8.000\,\mathrm{cm^3}.\]
Por tanto,
\[\rho = \frac{78.42}{8.000} \,\mathrm{g/cm^3} = 9.8025\,\mathrm{g/cm^3}.\]
Si las cuatro entradas pueden tratarse como no correlacionadas, proposición 3.4 da
\[u_r^2(\rho) \approx u_r^2(m) + u_r^2(L) + u_r^2(W) + u_r^2(H).\]
Numéricamente,
\[u_r(m) \approx 3.8\times10^{-4},\]
\[u_r(L) = 1.25\times10^{-3},\]
\[u_r(W) = 2.5\times10^{-3},\]
y
\[u_r(H) = 5.0\times10^{-3}.\]
La altura domina claramente el presupuesto relativo. La incertidumbre relativa combinada es aproximadamente
\[u_r(\rho) \approx 5.74\times10^{-3},\]
y por tanto
\[u_c(\rho) \approx 0.056\,\mathrm{g/cm^3}.\]
Un reporte coherente es
\[\boxed{ \rho=9.803\,\mathrm{g/cm^3}, \qquad u_c(\rho)=0.056\,\mathrm{g/cm^3}. }\]
La estimación previa
\[\rho\sim10\,\mathrm{g/cm^3}\]
y el resultado propagado son compatibles.
Además, el presupuesto nos indica dónde convendría mejorar el experimento: medir mejor la dimensión más pequeña.
Caso D — Consumo diario de agua: medición y estimación Fermi
Supongamos que el medidor de agua de una vivienda indica al inicio del día
\[R_1=132.438\,\mathrm{m^3}\]
y al final
\[R_2=132.912\,\mathrm{m^3}.\]
El consumo medido es
\[V = R_2-R_1 = 0.474\,\mathrm{m^3} = 474\,\mathrm L.\]
Antes de mirar el medidor, una estimación tipo Fermi para una vivienda de cuatro personas podría ser
\[V_F \sim 4\,\mathrm{personas} \times 10^2\,\frac{\mathrm L}{\text{persona\,día}} \times 1\,\text{día} \sim 4\times10^2\,\mathrm L.\]
Las dos rutas producen la misma escala: \(474\,\mathrm L\)
frente a
\[400\,\mathrm L.\]
La concordancia no demuestra que el modelo Fermi sea exacto.
Muestra que no existe una discrepancia de escala que obligue inmediatamente a revisar el razonamiento.
Diferencia de lecturas y fuentes comunes
Supongamos que la resolución del medidor es \(\Delta=0.001\,\mathrm{m^3}.\) Para una lectura individual, bajo un modelo rectangular de cuantización,
\[u_{\mathrm{res}} = \frac{0.001}{\sqrt{12}}\,\mathrm{m^3}.\]
Si las cuantizaciones de las dos lecturas pueden tratarse como no correlacionadas,
\[u_c(V) = \sqrt{2}\,u_{\mathrm{res}} \approx 4.1\times10^{-4}\,\mathrm{m^3} \approx 0.41\,\mathrm L.\]
Pero un desplazamiento aditivo común del cero del medidor aparece en ambas lecturas como \(R_1=A+C, \qquad R_2=B+C,\)
y se cancela en
\[R_2-R_1=B-A.\]
En cambio, un error multiplicativo de escala no se cancela de la misma manera. Este caso reúne §6, §8, §10, §11 y §12 en un solo problema.
Medición de un día no equivale a consumo “típico”
El resultado
\[474\,\mathrm L\]
puede describir razonablemente el consumo de ese día bajo el modelo del medidor.
No basta, por sí solo, para afirmar que el consumo diario típico de la vivienda es \(474\,\mathrm L.\) Para esa nueva pregunta tendríamos que modelar variaciones entre días, ocupación, estación, hábitos y otros factores.
Aquí aparece una distinción central del capítulo:
\[\boxed{ \text{cambiar la pregunta física} \Longrightarrow \text{cambiar el mensurando y el modelo de incertidumbre}. }\]
Red conceptual de los cuatro casos
| Caso | Mensurando | Modelo principal | Herramienta dominante | Control final |
|---|---|---|---|---|
| Diámetro | longitud de la pieza | media de indicaciones | tipo A + resolución | reporte explícito |
| Período | tiempo por oscilación | \(T=t/N\) | sensibilidad y propagación | escala previa |
| Densidad | masa por volumen | \(\rho=m/(LWH)\) | incertidumbre relativa | entrada dominante |
| Agua diaria | volumen consumido | \(V=R_2-R_1\) | diferencia + correlación | ruta Fermi conceptualmente distinta |
La misma arquitectura reaparece con contenidos diferentes.
Eso es precisamente lo que debe aprenderse: no una colección de fórmulas, sino un modo de organizar problemas cuantitativos.
Ejercicio 3.27 — Diseñar una medición de período. Función pedagógica: Diseño experimental → Propagación → Diagnóstico
Se espera que un oscilador tenga un período cercano a
\[2\,\mathrm s.\]
Un cronómetro tiene resolución
\[0.01\,\mathrm s.\]
El efecto de reacción al iniciar y detener el cronómetro se modela mediante una semiamplitud
\[0.12\,\mathrm s\]
rectangular para el tiempo total.
Compara conceptualmente medir una sola oscilación con medir \(N=20\) oscilaciones.
Calcula la incertidumbre estándar debida al efecto de reacción sobre el período en ambos diseños.
Explica qué fuentes de inexactitud no quedarían necesariamente reducidas por un factor \(20\).
Indica qué dato adicional necesitarías para incorporar una componente tipo A.
Solución
La incertidumbre estándar del efecto de reacción sobre el tiempo total es
\[u_{\mathrm{reac}} = \frac{0.12}{\sqrt3}\,\mathrm s \approx 0.069\,\mathrm s.\]
Para una sola oscilación, \(T=t,\)
de modo que la contribución es aproximadamente
\[0.069\,\mathrm s.\]
Para veinte oscilaciones, \(T=\frac{t}{20},\)
y la contribución se reduce a
\[\boxed{ u_{\mathrm{reac}}(T) \approx \frac{0.069}{20}\,\mathrm s \approx 0.0035\,\mathrm s. }\]
No quedan necesariamente reducidos en la misma proporción un conteo incorrecto de ciclos, una deriva física del período, un sesgo del criterio de comienzo/final o un modelo inadecuado del movimiento. Para una componente tipo A necesitamos una serie de repeticiones del tiempo total —o del período inferido— bajo condiciones definidas.
Ejercicio 3.28 — Medición y estimación de un consumo doméstico. Función pedagógica: Integración → Dos rutas → Alcance del mensurando
Un medidor registra
\[R_1=241.205\,\mathrm{m^3}\]
al comienzo de un día y
\[R_2=241.661\,\mathrm{m^3}\]
al final. Su resolución es \(0.001\,\mathrm{m^3}.\) En la vivienda viven tres personas. Construye además una estimación Fermi usando
\[150\,\text{L/persona/día}.\]
Calcula el consumo medido.
Evalúa la componente estándar asociada a la resolución de la diferencia suponiendo cuantizaciones no correlacionadas.
Construye la estimación Fermi.
Compara ambas rutas.
Explica por qué el resultado de un solo día no determina todavía el consumo diario típico de la vivienda.
Solución
La diferencia es
\[V = 241.661-241.205 = 0.456\,\mathrm{m^3} = 456\,\mathrm L.\]
Para cada lectura,
\[u_{\mathrm{res}} = \frac{0.001}{\sqrt{12}}\,\mathrm{m^3}.\]
Para la diferencia,
\[u_c(V) = \sqrt2\,u_{\mathrm{res}} \approx 4.1\times10^{-4}\,\mathrm{m^3} \approx 0.41\,\mathrm L.\]
La estimación Fermi es
\[V_F \sim 3\,\mathrm{personas} \times 150\,\frac{\mathrm L}{\text{persona\,día}} \times 1\,\text{día} = 450\,\mathrm L.\]
Las rutas concuerdan notablemente en escala:
\[456\,\mathrm L \quad\text{frente a}\quad 450\,\mathrm L.\]
Esa concordancia no convierte el valor Fermi en medición ni prueba que el consumo sea estable día a día. Para hablar de consumo diario típico necesitaríamos observaciones de múltiples días y un modelo explícito de variabilidad temporal.
Cierre: una misma disciplina para medir y estimar
Los cuatro casos muestran que la parte difícil rara vez es la aritmética.
La dificultad está en decidir:
qué se está midiendo;
qué modelo se está usando;
qué fuentes de incertidumbre pertenecen al problema;
qué dependencias existen;
qué nivel de precisión está justificado;
qué comparación externa puede revelar una incoherencia.
Podemos condensar el capítulo hasta aquí en una sola disciplina:
\[\boxed{ \text{hacer visible la cadena que conecta el fenómeno con el número reportado}. }\]
En §14 cerraremos el capítulo preguntando qué tipo de afirmación permite finalmente esa cadena y, con igual importancia, qué afirmaciones no permite.
14. Qué puede y qué no puede decir una medición
Volver a la pregunta rectora
El capítulo comenzó con una pregunta:
\[\boxed{ \text{¿qué información física contiene realmente un resultado de medición?} }\]
Después de estudiar mensurandos, indicaciones, resolución, repetición, error, incertidumbre, propagación, reporte, estimación y robustez, podemos responderla con mayor precisión. Un resultado de medición no es simplemente un número obtenido mediante un instrumento. Tampoco es una confesión de ignorancia.
Es una atribución cuantitativa al mensurando construida a partir de:
una pregunta física;
un procedimiento;
un modelo de medición;
observaciones;
correcciones;
información sobre las fuentes relevantes de incertidumbre;
reglas explícitas de evaluación y reporte.55
Por eso el principio epistemológico que ha atravesado todo el capítulo puede escribirse como
\[\boxed{ \text{resultado de medición} \neq \text{valor matemático exacto del mensurando}. }\]
Pero de esta desigualdad no se sigue que una medición sea arbitraria. El objetivo de la metrología es precisamente hacer controlable, comunicable y cuantitativa la información experimental disponible.
Qué sí puede decir una medición bien formulada
Supongamos que reportamos
\[d=20.1400\,\mathrm{mm}, \qquad u_c(d)=0.0043\,\mathrm{mm}.\]
Bajo el modelo y procedimiento declarados, este resultado puede sostener afirmaciones como:
el valor atribuido al mensurando está centrado alrededor de \[20.1400\,\mathrm{mm};\]
la información utilizada conduce a una incertidumbre estándar combinada de \[0.0043\,\mathrm{mm};\]
determinadas fuentes de variación o corrección han sido incorporadas al presupuesto;
el resultado puede compararse con otros resultados si entendemos la semántica de sus incertidumbres y las condiciones de medición;
la escala física del mensurando está bien determinada para el propósito experimental considerado.
La medición permite formular una afirmación cuantitativa condicionada por un modelo y por información experimental explícita. Eso es mucho más que una mera lectura.
Qué no puede decir por sí sola
El mismo resultado
\[d=20.1400\,\mathrm{mm}, \qquad u_c(d)=0.0043\,\mathrm{mm}\]
no autoriza automáticamente afirmaciones como:
«El diámetro verdadero es exactamente \(20.1400\,000\ldots\,\mathrm{mm}\).»
Tampoco permite concluir, sin información adicional:
«La probabilidad de que el valor verdadero esté entre \(20.1357\) y \(20.1443\,\mathrm{mm}\) es del 68 %.»
Ni:
«Toda dimensión de esta pieza es conocida con esa incertidumbre.»
Ni:
«Cualquier otro instrumento que muestre \(20.1400\,\mathrm{mm}\) está de acuerdo con éste.»
Cada una de estas afirmaciones introduce contenido que no está contenido automáticamente en la escritura del resultado. Por tanto,
\[\boxed{ \begin{gathered}\text{un resultado justifica sólo las}\\\text{conclusiones sostenidas por su}\\\text{mensurando, su modelo y la}\\\text{semántica declarada de la}\\\text{incertidumbre}\end{gathered}. }\]
Incertidumbre no significa ignorancia total
En §4 definimos la incertidumbre como información cuantitativa que caracteriza la dispersión de valores atribuibles al mensurando a partir de la información utilizada.56
Esto significa que
\[u>0\]
no equivale a decir:
«No sabemos nada.»
De hecho, una incertidumbre evaluada cuidadosamente expresa cuánto sabemos y bajo qué estructura lo sabemos.
Consideremos dos situaciones:
Situación A
Sólo sabemos que una longitud está probablemente entre
\[1\,\mathrm m \quad\text{y}\quad 10\,\mathrm m.\]
Situación B
Un procedimiento calibrado conduce a
\[L=2.417\,\mathrm m, \qquad u_c(L)=0.003\,\mathrm m.\]
Ambas contienen incertidumbre. Pero no contienen la misma cantidad ni la misma calidad de información. La existencia de incertidumbre no destruye el conocimiento experimental.
Lo estructura.
Incertidumbre pequeña no garantiza por sí sola exactitud
Aquí conviene recuperar la distinción entre precisión de medición y exactitud de medición. La precisión está relacionada con la cercanía entre indicaciones o valores medidos obtenidos mediante mediciones repetidas bajo condiciones especificadas. La exactitud se refiere cualitativamente a la cercanía entre un valor medido y un valor verdadero del mensurando; el VIM no la trata como una magnitud que deba representarse mediante un único número.57
Un procedimiento puede ser muy repetible y producir una serie estrecha:
\[10.0001,\quad 10.0002,\quad 10.0001,\quad 10.0002.\]
Pero si existe un desplazamiento sistemático no reconocido de
\[0.5,\]
la gran repetibilidad no convierte automáticamente el resultado en exacto. Por eso,
\[\boxed{ \text{alta precisión} \not\Rightarrow \text{alta exactitud}. }\]
Y, del mismo modo,
\[\boxed{ \text{incertidumbre evaluada dentro de un modelo} \not\Rightarrow \text{modelo completo}. }\]
El presupuesto de incertidumbre no certifica automáticamente el modelo
Supongamos que medimos repetidamente el diámetro de una pieza no perfectamente circular, siempre en la misma orientación. Podríamos obtener una dispersión extremadamente pequeña. Podríamos incluir además la resolución del calibre y una corrección de calibración.
El presupuesto podría parecer excelente. Sin embargo, si la pregunta física era
«¿cuál es el diámetro medio de la pieza?»
y sólo medimos una orientación, entonces el problema principal no está en la aritmética de la propagación. Está en el modelo del mensurando y del procedimiento. Una evaluación de incertidumbre no puede rescatar una pregunta mal especificada.
En forma esquemática,
\[\boxed{ \text{propagación correcta} + \text{modelo inadecuado} \neq \text{resultado adecuado}. }\]
Ésta es una consecuencia directa del principio 3.1 y principio 3.7.
La incertidumbre sólo incluye lo que el análisis ha modelado
Un presupuesto de incertidumbre puede contener:
repetibilidad;
resolución;
calibración;
correcciones;
condiciones ambientales;
covarianzas;
parámetros del modelo.
Pero una fuente relevante no aparece mágicamente en el resultado por el solo hecho de escribir
\[u_c.\]
Si una contribución importante no ha sido reconocida, caracterizada o incorporada de manera adecuada, el número final no puede compensar esa omisión. Por eso debemos interpretar
\[u_c(y)\]
como
incertidumbre estándar combinada según el modelo y la información utilizados,
no como
medida absoluta y definitiva de toda limitación concebible de la experiencia.
Esta disciplina evita tratar el presupuesto de incertidumbre como un ritual algebraico.
Un intervalo sólo significa lo que hemos declarado que significa
En §§4 y 8 insistimos en que el símbolo
\[\pm\]
no posee una semántica universal. La escritura
\[x\pm u\]
no establece por sí misma una probabilidad de cobertura. Una incertidumbre estándar, una incertidumbre expandida, una tolerancia y una cota determinista son objetos diferentes. Si reportamos una incertidumbre expandida
\[U=ku_c,\]
el factor de cobertura y la interpretación empleada deben quedar declarados.58
Por tanto,
\[\boxed{ \text{forma gráfica semejante} \not\Rightarrow \text{significado metrológico semejante}. }\]
La notación debe seguir a la semántica, no sustituirla.
Exactitud matemática y precisión física pertenecen a niveles distintos
Supongamos que
\[a=1.24\,\mathrm m, \qquad b=0.73\,\mathrm m.\]
Matemáticamente, \(1.24\times0.73=0.9052\)
es una igualdad exacta entre números decimales finitos. Pero si
\[a\]
y
\[b\]
son valores procedentes de mediciones, la igualdad matemática no implica que el área física sea conocida exactamente como \(0.9052\,\mathrm{m^2}.\) La distinción fundamental es
\[\boxed{\begin{gathered} \text{exactitud de la operación matemática}\\[2pt] \neq\\[2pt] \text{exactitud del conocimiento físico de sus entradas}. \end{gathered}}\]
Este punto explica por qué las cifras producidas por una calculadora no determinan el número de cifras que deben reportarse. La matemática puede operar exactamente con representaciones numéricas cuya procedencia física tiene alcance finito.
Una medición responde una pregunta, no todas las preguntas cercanas
En §13 medimos un consumo de agua durante un día.
El mensurando podía formularse como:
volumen registrado como consumido entre dos instantes determinados.
Ese resultado no responde automáticamente:
¿cuál es el consumo diario típico de la vivienda durante el año?
La segunda pregunta requiere nueva información:
muchos días;
variabilidad estacional;
cambios de ocupación;
hábitos;
posibles tendencias.
Por eso,
\[\boxed{ \text{generalizar el resultado} = \text{formular una nueva inferencia}. }\]
Y una nueva inferencia requiere justificar su propio modelo.
Medir una muestra temporal, espacial o poblacional no autoriza automáticamente una afirmación universal.
Comparar resultados exige comparar también sus modelos
Supongamos dos laboratorios que reportan
\[x_A=10.000, \qquad u_c(x_A)=0.010,\]
y
\[x_B=10.018, \qquad u_c(x_B)=0.012.\]
La comparación no debe reducirse a observar cuántos decimales coinciden.
También debemos preguntar:
¿miden el mismo mensurando?;
¿bajo condiciones comparables?;
¿sus incertidumbres significan lo mismo?;
¿comparten patrones o correcciones que introduzcan correlaciones?;
¿utilizan modelos compatibles?
Incluso la diferencia
\[x_B-x_A\]
es una nueva magnitud derivada cuya interpretación depende de esas relaciones. Por tanto,
\[\boxed{ \text{comparar números} \neq \text{comparar automáticamente resultados de medición}. }\]
La comparación física conserva la estructura del problema original.
Medición y estimación no compiten
Las §§10–12 introdujeron estimaciones de escala y estimaciones tipo Fermi.
Puede parecer que existen dos métodos rivales:
\[\text{medir} \qquad\text{vs.}\qquad \text{estimar}.\]
No es así.
Una estimación puede:
anticipar la escala de una medición;
detectar errores de unidades;
señalar un resultado implausible;
ayudar a diseñar el rango de un instrumento;
indicar qué precisión es realmente necesaria.
Una medición puede, a su vez:
reemplazar una escala tentativa por información experimental;
revelar que una hipótesis de la estimación era pobre;
proporcionar valores para estimaciones posteriores.
La relación correcta es
\[\boxed{ \text{estimación} \longleftrightarrow \text{medición}, }\]
con funciones distintas pero complementarias.
Reportar un resultado es construir un argumento compacto
Un buen reporte experimental puede ser breve, pero no es intelectualmente simple. Cuando escribimos
\[y, \qquad u_c(y), \qquad \text{unidad},\]
estamos condensando una cadena:
\[\boxed{ \text{mensurando} \to \text{modelo} \to \text{procedimiento} \to \text{datos} \to \text{evaluación} \to \text{resultado}. }\]
El reporte final es la conclusión visible de ese argumento. Por eso un número aislado puede ser insuficiente incluso si su aritmética es impecable. Y por eso documentar las hipótesis no es burocracia externa a la física.
Forma parte de la física experimental.
Prueba de cierre: seis preguntas antes de aceptar una conclusión
Antes de aceptar una afirmación basada en una medición, conviene poder responder:
Mensurando: ¿qué magnitud se pretendía medir?
Procedimiento: ¿cómo se obtuvieron las indicaciones?
Modelo: ¿qué relación conecta observaciones y mensurando?
Incertidumbre: ¿qué significa la incertidumbre declarada y qué fuentes incluye?
Alcance: ¿a qué condiciones, sistema, intervalo temporal o población se refiere?
Conclusión: ¿la afirmación final añade algo que el resultado no justifica?
Podemos condensarlo como
\[\boxed{ \text{buena inferencia física} = \text{resultado} + \text{modelo} + \text{alcance declarado}. }\]
Esta fórmula no es algebraica. Es una regla de lectura científica.
Ejercicio 3.29 — Crítica epistemológica de un reporte. Función pedagógica: Diagnóstico → Distinciones → Reconstrucción
Un estudiante escribe:
«Medí cinco veces una pieza con un calibre digital. Obtuve una media de \(25.000\,\mathrm{mm}\) y una incertidumbre estándar combinada de \(0.002\,\mathrm{mm}\). Por tanto, el diámetro verdadero de la pieza está entre \(24.998\) y \(25.002\,\mathrm{mm}\) con certeza, la pieza es perfectamente circular y cualquier otro laboratorio debería obtener un valor dentro de ese intervalo.»
Analiza separadamente las tres conclusiones:
«el valor verdadero está dentro del intervalo con certeza»;
«la pieza es perfectamente circular»;
«cualquier otro laboratorio debería obtener un valor dentro del intervalo».
Para cada una, indica qué información adicional sería necesaria.
Solución
1. Intervalo garantizado
La incertidumbre estándar combinada
\[u_c=0.002\,\mathrm{mm}\]
no es, por sí sola, una cota determinista que garantice
\[24.998 \le d \le 25.002\,\mathrm{mm}.\]
Para interpretar un intervalo necesitamos declarar qué tipo de incertidumbre o cobertura se está usando y bajo qué modelo.
2. Circularidad
Una serie de mediciones de diámetro en una sola orientación puede ser muy repetible y, aun así, no decir nada suficiente sobre otras orientaciones. Para evaluar circularidad habría que definir el mensurando correspondiente y medir la geometría de la pieza en múltiples direcciones o mediante un procedimiento apropiado.
3. Otro laboratorio
Otro laboratorio puede usar un procedimiento, patrón, corrección, temperatura, fuerza de contacto o modelo de incertidumbre distintos. La comparabilidad exige verificar que ambos resultados se refieren al mismo mensurando bajo condiciones y modelos compatibles. El diagnóstico general es
\[\boxed{ \text{las tres conclusiones exceden la información explícitamente proporcionada}. }\]
Ejercicio 3.30 — Qué puede concluirse y qué no. Función pedagógica: Síntesis final → Transferencia
Una experiencia produce
\[T=1.5806\,\mathrm s, \qquad u_c(T)=0.0030\,\mathrm s,\]
para el período de un sistema oscilante durante una sesión experimental.
Clasifica cada afirmación como:
justificada por el resultado y el modelo declarado;
posiblemente justificable con información adicional;
no justificada por los datos proporcionados.
A. «La escala temporal del período es del orden de un segundo.»
B. «El período matemáticamente exacto del sistema es \(1.5806000\ldots\,\mathrm s\).»
C. «La incertidumbre estándar evaluada es aproximadamente \(0.0030\,\mathrm s\).»
D. «Mañana el sistema tendrá exactamente el mismo período.»
E. «Un resultado de \(15.81\,\mathrm s\) obtenido con el mismo montaje merece una revisión inmediata.»
F. «El sistema es perfectamente periódico para todo tiempo.»
Solución
A — Justificada. El resultado sitúa claramente la escala temporal alrededor de
\[10^0\,\mathrm s.\]
B — No justificada. Los dígitos reportados no establecen un valor matemático exacto del mensurando.
C — Justificada, si \(u_c(T)\) ha sido evaluada y reportada como incertidumbre estándar combinada según el modelo indicado.
D — Posiblemente justificable con información adicional. Requeriría estudiar estabilidad temporal y condiciones del sistema.
E — Justificada como diagnóstico de plausibilidad. Difiere en un factor
\[10\]
de la escala observada y estimada; antes de aceptarlo conviene revisar unidades, conteo de oscilaciones, factor \(N\) y procedimiento.
F — No justificada. Una medición de período durante una sesión no demuestra periodicidad matemática perfecta para todo tiempo.
La síntesis final es:
\[\boxed{\begin{gathered} \begin{gathered}\text{una medición informa con precisión}\\\text{sobre una pregunta delimitada;}\end{gathered}\\[2pt] \begin{gathered}\text{no convierte esa pregunta en una}\\\text{afirmación ilimitada sobre el sistema}\end{gathered}. \end{gathered}}\]
Red final del capítulo
Podemos ahora reconstruir la arquitectura completa.
De la experiencia al resultado
\[\text{sistema físico} \to \text{mensurando} \to \text{procedimiento} \to \text{indicación}.\]
De las indicaciones a la información metrológica
\[\text{repetición} + \text{resolución} + \text{calibración} + \text{modelo} \to \text{incertidumbre}.\]
De las entradas a la magnitud derivada
\[\text{modelo de medición} \to \text{coeficientes de sensibilidad} \to \text{propagación}.\]
Del cálculo al reporte
\[\text{valor} + \text{unidad} + \text{incertidumbre explícita} \to \text{resultado comunicado}.\]
Del resultado al juicio físico
\[\text{resultado} + \text{estimación} + \text{robustez} + \text{alcance del modelo} \to \text{conclusión físicamente defendible}.\]
La lección global puede resumirse en una sola regla:
\[\boxed{\begin{gathered} \begin{gathered}\text{la física experimental no elimina la}\\\text{incertidumbre;}\end{gathered}\\[2pt] \begin{gathered}\text{aprende a describir qué sabemos,}\\\text{cómo lo sabemos y hasta dónde llega}\\\text{esa afirmación}\end{gathered}. \end{gathered}}\]
Transición al capítulo 4
Hasta aquí hemos tratado magnitudes que podían representarse mediante un valor escalar:
longitud;
masa;
tiempo;
temperatura;
volumen;
densidad;
consumo.
Pero muchos problemas físicos exigen algo más que tamaño. Una posición requiere especificar dónde. Un desplazamiento requiere tamaño y dirección.
Una velocidad ya no queda caracterizada completamente por un número positivo. La siguiente capa conceptual será entonces geométrica. Pasaremos de preguntas como
\[\text{¿cuánto?}\]
a preguntas como
\[\text{¿dónde?} \qquad \text{¿en qué dirección?} \qquad \text{¿respecto de qué referencia?}\]
El siguiente capítulo es:
\[\boxed{ \text{capítulo 4 — Espacio euclídeo, vectores y marcos de referencia}. }\]
La disciplina adquirida aquí seguirá vigente.
También allí tendremos que preguntar qué magnitud representa cada objeto matemático, cómo se relaciona con la experiencia y qué información física justifica cada afirmación.
Notas
JCGM 200:2012 (VIM3), término 2.3, measurand.↩︎
JCGM 200:2012 (VIM3), término 2.1, measurement.↩︎
JCGM 200:2012 (VIM3), término 2.3, measurand.↩︎
JCGM 200:2012 (VIM3), término 4.1, indication.↩︎
JCGM 200:2012 (VIM3), término 2.9, measurement result. El VIM señala que un resultado suele expresarse mediante un valor medido acompañado por una incertidumbre.↩︎
JCGM 200:2012 (VIM3), términos 4.14–4.15, resolution y resolution of a displaying device.↩︎
JCGM 200:2012 (VIM3), término 2.26, measurement uncertainty.↩︎
JCGM 200:2012 (VIM3), términos 2.28–2.29, evaluaciones tipo A y tipo B de la incertidumbre de medición. Véase también JCGM 100:2008 (GUM) y JCGM GUM-1:2023.↩︎
JCGM 200:2012 (VIM3), término 4.1, indication. La formulación del texto es una adaptación pedagógica del vocabulario metrológico.↩︎
JCGM 200:2012 (VIM3), término 4.14, resolution: menor cambio de la magnitud medida que causa un cambio perceptible en la indicación correspondiente.↩︎
JCGM 200:2012 (VIM3), término 4.14, resolution: menor cambio de la magnitud medida que causa un cambio perceptible en la indicación correspondiente.↩︎
JCGM 200:2012 (VIM3), término 4.15, resolution of a displaying device. Se usa aquí para distinguir la granularidad de la visualización de otras propiedades del sistema de medición.↩︎
JCGM 200:2012 (VIM3), término 2.13, measurement accuracy. Se adelanta sólo la distinción terminológica; el tratamiento conceptual detallado aparece en §4.↩︎
JCGM 200:2012 (VIM3), término 4.16, discrimination threshold. La sección lo utiliza para evitar identificar toda capacidad de discriminación con un único número de pantalla.↩︎
JCGM 200:2012 (VIM3), término 2.15, measurement precision. El VIM la define mediante la proximidad entre indicaciones o valores medidos obtenidos por mediciones repetidas bajo condiciones especificadas y advierte que no debe utilizarse como sinónimo de exactitud.↩︎
JCGM 200:2012 (VIM3), término 2.15, measurement precision. El VIM la define mediante la proximidad entre indicaciones o valores medidos obtenidos por mediciones repetidas bajo condiciones especificadas y advierte que no debe utilizarse como sinónimo de exactitud.↩︎
JCGM 200:2012 (VIM3), término 2.21, measurement repeatability. Se usa aquí para conectar la precisión con condiciones de repetibilidad sin desarrollar todavía toda la taxonomía metrológica de condiciones.↩︎
JCGM 100:2008 (GUM) y JCGM 200:2012 (VIM3), términos 2.28–2.30. La relación entre análisis estadístico de series, evaluación tipo A e incertidumbre estándar se desarrolla en §5.↩︎
JCGM 200:2012 (VIM3), término 2.15, measurement precision. El VIM la define mediante la proximidad entre indicaciones o valores medidos obtenidos por mediciones repetidas bajo condiciones especificadas y advierte que no debe utilizarse como sinónimo de exactitud.↩︎
JCGM 200:2012 (VIM3), término 2.16, measurement error: valor medido menos un valor de referencia.↩︎
JCGM 200:2012 (VIM3), término 2.16, measurement error: valor medido menos un valor de referencia.↩︎
JCGM 200:2012 (VIM3), término 2.53, correction. Se utiliza aquí en el sentido de compensación por un efecto sistemático estimado.↩︎
JCGM 200:2012 (VIM3), términos 2.17 y 2.19, systematic measurement error y random measurement error.↩︎
JCGM 200:2012 (VIM3), término 2.18, measurement bias: estimación del error sistemático.↩︎
JCGM 200:2012 (VIM3), término 2.26, measurement uncertainty. La formulación operativa del texto se mantiene deliberadamente compatible con la definición normativa sin introducir todavía toda la maquinaria GUM.↩︎
JCGM 200:2012 (VIM3), término 2.26, measurement uncertainty. La formulación operativa del texto se mantiene deliberadamente compatible con la definición normativa sin introducir todavía toda la maquinaria GUM.↩︎
JCGM 200:2012 (VIM3), términos 2.48–2.52, sobre modelo de medición, cantidades de entrada y salida e influencia. JCGM GUM-6:2020 amplía sistemáticamente la construcción y uso de modelos de medición.↩︎
JCGM 200:2012 (VIM3), términos 2.28–2.29; JCGM 100:2008 (GUM), marco de evaluación de componentes de incertidumbre.↩︎
JCGM 200:2012 (VIM3), término 2.28, Type A evaluation of measurement uncertainty.↩︎
JCGM 200:2012 (VIM3), término 2.29, Type B evaluation of measurement uncertainty.↩︎
JCGM 200:2012 (VIM3), término 2.30, standard measurement uncertainty. El tratamiento de incertidumbre expandida y factores de cobertura se desarrollará en §8.↩︎
JCGM 200:2012, VIM3, §2.31, “combined standard measurement uncertainty”; la nota asociada indica que, cuando existen correlaciones entre cantidades de entrada, deben incorporarse covarianzas.↩︎
JCGM 100:2008, GUM, §5.1.2, ecuación (10), para cantidades de entrada no correlacionadas.↩︎
JCGM 100:2008, GUM, §5.1.5; para un modelo lineal, la combinación por varianzas es directa bajo la hipótesis de entradas no correlacionadas.↩︎
JCGM 100:2008, GUM, §§5.2.1–5.2.2, ecuaciones (13)–(16), donde aparecen covarianzas y coeficientes de correlación.↩︎
JCGM 100:2008, GUM, §§5.2.4–5.2.5; una misma referencia, instrumento o influencia común puede inducir correlaciones significativas.↩︎
JCGM 100:2008, GUM, §5.1.6, ecuación (12), para productos de potencias con entradas no correlacionadas y en el régimen de propagación adoptado.↩︎
JCGM 100:2008, §5.1.3: los coeficientes de sensibilidad se expresan mediante derivadas parciales del modelo evaluadas en las estimaciones de entrada.↩︎
JCGM 100:2008, §§5.1.2–5.1.5 y §5.2.2: ley de propagación de incertidumbre, primero para entradas no correlacionadas y luego incluyendo covarianzas.↩︎
JCGM 100:2008, §5.1.2 nota y §5.1.5: cuando la no linealidad del modelo es significativa en la región relevante, la aproximación lineal puede requerir términos de orden superior.↩︎
JCGM 100:2008/Amd.1:2026, Nonlinearity in measurement models: añade una advertencia explícita sobre no linealidad significativa y remite, según el caso, a términos de orden superior o a propagación mediante Monte Carlo; también señala que la no linealidad puede afectar la evaluación de la estimación de salida.↩︎
JCGM 100:2008, §7.2.6. Recomienda evitar un número excesivo de dígitos en \(y\), \(u_c(y)\) y \(U\); usualmente bastan como máximo dos cifras significativas para las incertidumbres, con redondeo coherente de la estimación.↩︎
JCGM 100:2008, §§7.2.3–7.2.4. Para reportes con incertidumbre expandida, la GUM pide declarar \(U\), el factor de cobertura \(k\) y, cuando se atribuye un nivel de confianza, la base utilizada.↩︎
JCGM 200:2012 (VIM3), entrada sobre expanded measurement uncertainty.↩︎
JCGM 100:2008, §§6.2–6.3 y 7.2.3. La relación entre \(k\), el intervalo expandido y una probabilidad de cobertura depende de las hipótesis estadísticas empleadas.↩︎
JCGM 200:2012 (VIM3), entrada sobre coverage factor.↩︎
Taylor, B. N. y Kuyatt, C. E., Guidelines for Evaluating and Expressing the Uncertainty of NIST Measurement Results, NIST TN 1297, §7. La política de reporte exige identificar \(U\) y \(k\) o reportar \(u_c\), y documentar el procedimiento de evaluación.↩︎
JCGM 100:2008, §7.2.6. Recomienda evitar un número excesivo de dígitos en \(y\), \(u_c(y)\) y \(U\); usualmente bastan como máximo dos cifras significativas para las incertidumbres, con redondeo coherente de la estimación.↩︎
JCGM 100:2008, §7.2.2, especialmente la nota asociada a los formatos de reporte de \(u_c(y)\): la forma con \(\pm\) está listada, pero se recomienda evitarla siempre que sea posible porque puede confundirse con un intervalo de alta cobertura o con una incertidumbre expandida.↩︎
JCGM 100:2008, §7.2.2, especialmente la nota asociada a los formatos de reporte de \(u_c(y)\): la forma con \(\pm\) está listada, pero se recomienda evitarla siempre que sea posible porque puede confundirse con un intervalo de alta cobertura o con una incertidumbre expandida.↩︎
JCGM 100:2008, §§7.2.3–7.2.4. Para reportes con incertidumbre expandida, la GUM pide declarar \(U\), el factor de cobertura \(k\) y, cuando se atribuye un nivel de confianza, la base utilizada.↩︎
Taylor, B. N. y Kuyatt, C. E., Guidelines for Evaluating and Expressing the Uncertainty of NIST Measurement Results, NIST TN 1297, §7. La política de reporte exige identificar \(U\) y \(k\) o reportar \(u_c\), y documentar el procedimiento de evaluación.↩︎
JCGM 100:2008, §5.1.6 y notas asociadas a la forma relativa de la ley de propagación; la incertidumbre estándar relativa se obtiene normalizando una incertidumbre estándar por la magnitud de la estimación no nula correspondiente.↩︎
JCGM 100:2008, §5.1.6, ecuación (12): forma relativa de la ley de propagación para un producto de potencias bajo las hipótesis indicadas.↩︎
JCGM 200:2012 (VIM3), §2.9, measurement result.↩︎
JCGM 200:2012 (VIM3), §2.26, measurement uncertainty.↩︎
JCGM 200:2012 (VIM3), §§2.13 y 2.15, measurement accuracy y measurement precision.↩︎
JCGM 100:2008 (GUM), tratamiento del reporte de incertidumbre estándar y expandida; véanse también VIM3 §§2.35–2.38.↩︎